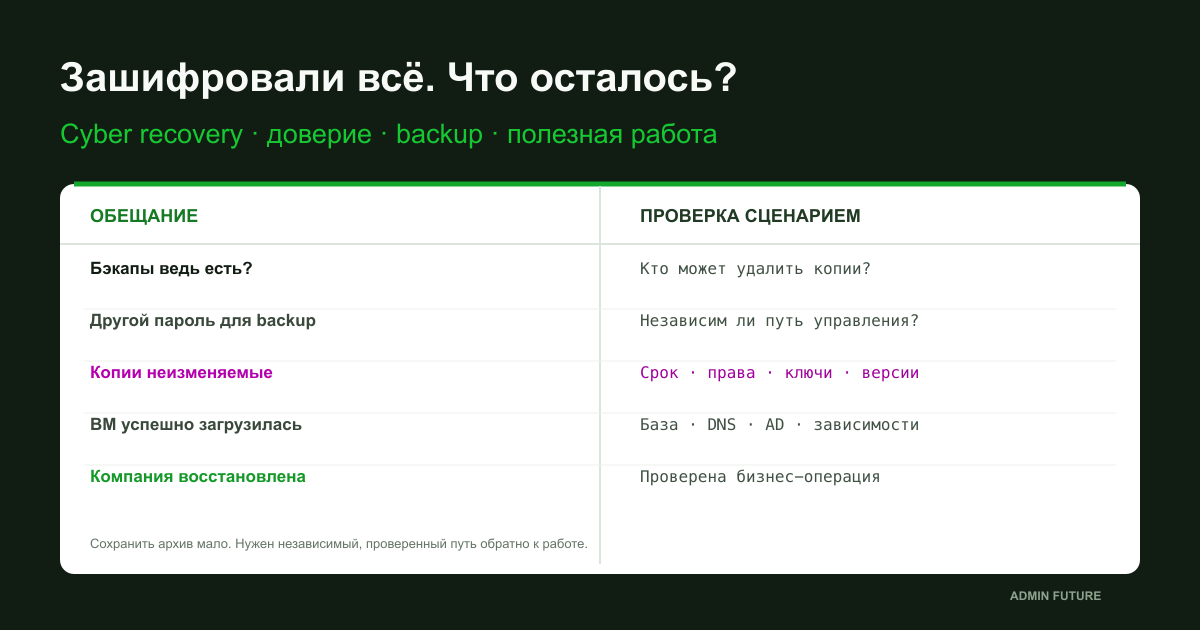
«Бэкапы ведь есть?» — спрашивает директор. Администратор открывает консоль. Последняя задача зелёная, объём привычный, ошибок нет. Ответ почти готов: «Да, каждую ночь». Но вместо этого появляется другой вопрос: «А кто может их удалить?»
Через полчаса выясняется неприятное. Сервер резервного копирования входит в тот же домен. Репозиторий доступен с привычного административного компьютера. Учётная запись, которой обслуживают production, управляет и архивом. Пароль от облака лежит в том же хранилище секретов, которое открывается через корпоративную почту. Копии существуют. Независимого пути назад пока нет.
Это учебный кейс о вымышленной компании, не описание реального заказчика и не обещание абсолютной защиты. Мы построим систему, в которой компрометация обычного рабочего контура не должна автоматически уничтожать возможность восстановления. Каждое «предусмотрено» проверим сценарием отказа или атаки. Настройки production меняются только по отдельному согласованному плану; команды ниже предназначены для ограниченного сбора и проверки, а не массовой перестройки инфраструктуры.
1. Компания восстанавливает не серверы, а свою способность работать
В нашей истории есть офис, склад, сотрудники на удалёнке, AD, файловый сервер, SQL и приложение учёта. Руководитель называет критичным «сервер бухгалтерии». Однако отгрузку останавливает не только его выключение. Нужны каталог пользователей, разрешение имён, лицензирование, база, обмен и рабочие места. Иногда ещё принтер этикеток и доступ к внешнему сервису.
Поэтому первая встреча проходит не у панели гипервизора. Администратор садится с руководителями подразделений и спрашивает: какую конкретную операцию нельзя потерять, сколько времени допустимо выполнять её вручную, кто подтвердит восстановление? Ответ «всё критично» превращают в очередность. Иначе все ресурсы будут первыми, а реального первого не окажется.
Появляются три режима: минимально жизнеспособная работа, ограниченная работа и полный сервис. Склад может временно оформлять часть операций по согласованной бумажной процедуре. Бухгалтерия может переждать час, но не потерять подтверждённые платежи. Обмен с партнёром можно вернуть позже, если его повторный запуск не создаст дубли.
Важно проверить эти предположения с бизнесом. Администратор не назначает от имени компании допустимую потерю документов. Он показывает техническую цену решения и получает согласованные критерии.
2. RTO и RPO должны быть проверяемыми обещаниями
RTO — целевое время восстановления, RPO — допустимая потеря данных во времени. Но ночная копия не гарантирует автоматически ни одно из них. Если архив читается сутки, обещание «вернёмся за четыре часа» неправдоподобно. Если последние копии заражены, фактическая доверенная точка может оказаться старше планового RPO.
Запишем условные требования нашей компании. Это примеры для расчёта, не универсальные нормы:
| Услуга | Цель учебного кейса | Приёмка |
|---|---|---|
| Учёт и склад | Минимальная работа за 4 часа; данные не старше 30 минут при доступной доверенной цепочке | Создать тестовый заказ, сохранить и прочитать его с другого рабочего места |
| Файлы подразделений | Критичный набор за 8 часов, остальное позже | Проверить содержимое, ACL и чтение/запись владельцем |
| Почта и интеграции | Отдельная очередь по влиянию на операции | Контролируемая отправка без повторения настоящих уведомлений |
У каждого обещания появляется точка начала отсчёта: обнаружение, объявление аварии или старт восстановления. Без этого красивый RTO можно получить простым исключением времени расследования. В нашей тренировке фиксируем весь путь от объявления сценария до приёмки владельцем услуги.
3. Модель угроз: какую именно власть получил атакующий?
«Шифровальщик» — слишком широкое описание для архитектуры. Возможна компрометация пользовательского компьютера, административной станции, доменной привилегированной записи, backup-консоли, облачного аккаунта или гипервизора. Разные исходные права дают разные пути уничтожения.
Начинаем с четырёх сценариев. Атакующий получил пользователя. Атакующий получил обычного серверного администратора. Атакующий контролирует backup-сервер. Наконец, недоступен весь основной сайт вместе с доменом и привычной связью. Последний сценарий — проверка восстановления, а не утверждение, что все эти события всегда происходят одновременно.
Для каждого рисуем путь: какие учётные данные доступны, куда можно войти, что удалить, какие журналы стереть, какие ключи отозвать. Цель не в том, чтобы составить бесконечный каталог угроз. Нужно обнаружить кратчайшие переходы от одного захваченного места к потере всех копий.
В нашей истории кратчайший путь проходит через общий административный контекст. Это установленное свойство вымышленной исходной схемы. В вашей компании его нельзя объявить без инвентаризации прав и реальных способов подключения.
4. Инвентаризация начинается с зависимостей и владельцев
Список ВМ нужен, но недостаточен. Для услуги записывают владельца, систему данных, версию, способ аутентификации, DNS, сертификаты, лицензии, внешние соединения и способ установки. Отдельно — где находятся конфигурация и секреты и как их получить без работающего production.
Особенно неприятны тихие зависимости: задача под личной записью бывшего сотрудника, ключ шифрования в профиле администратора, привязка лицензии к железу, скрипт только на потерянном ноутбуке. Пока всё включено, они не выглядят проблемой. В восстановлении превращаются в остановку.
# Authorized local Windows inventory. PowerShell 5.1. Read-only.
Get-Date -Format o
Get-CimInstance Win32_ComputerSystem |
    Select-Object Name,Domain,PartOfDomain
Get-CimInstance Win32_Service |
    Where-Object { $_.StartName -notmatch '^(LocalSystem|NT AUTHORITY\\|NT SERVICE\\)' } |
    Select-Object Name,State,StartMode,StartName
Get-ScheduledTask |
    Select-Object TaskPath,TaskName,State,
        @{Name='RunAs';Expression={$_.Principal.UserId}}
# This does not reveal stored passwords or all internal application credentials.
Команды показывают часть идентичностей Windows-служб и заданий. Они не перечисляют все внутренние credentials приложений, не доказывают избыточность прав и не извлекают пароли. Сбор согласуется по узлам; не запускайте широкую инвентаризацию чужого контура. Ошибку доступа фиксируют отдельно, а не записывают сервис как отсутствующий.
Результат — карта зависимостей и список неизвестного. «Не знаем, как восстановить лицензию» становится конкретной задачей до аварии. Неопределённость, обнаруженная заранее, уже полезнее зелёной панели.
5. Три учётные записи — не три независимые границы
Разделяем повседневную работу, привилегированное управление production и управление backup. Но новое имя пользователя ещё не создаёт изоляцию. Если все три пароля вводят на одном заражённом компьютере или восстанавливают через одну захваченную почту, границы сходятся в одной точке.
Составляем матрицу полномочий: кто может запускать задачу, читать архив, восстанавливать данные, менять retention, удалять версии, управлять репозиторием и менять ключи. Эти действия не обязаны принадлежать одному оператору. Сервисная запись получает ровно требуемый для продукта доступ, а не удобные права администратора всей компании.
Нельзя без проверки утверждать, что backup-сервер обязательно запрещено включать в домен. Важнее выбранная модель доверия и последствия доменного захвата. Некоторые поддерживаемые схемы используют доменные компоненты, но нужны отдельные защитные границы, которые действительно переживают заявленный сценарий.
Увольнение, смена дежурного и восстановление доступа проверяют тоже. Если доступ существует только у одного человека, компания приобрела другой вид единственной точки отказа.
6. Защищённый путь управления: откуда вводят привилегированный пароль
Обычная станция администратора получает почту, открывает браузер и скачивает документы. Она не должна автоматически становиться доверенным источником всех инфраструктурных полномочий. Для привилегированной работы проектируют выделенный поддерживаемый путь: защищённая станция, контролируемый вход, необходимые промежуточные узлы и доступ только к назначенным системам.
Jump host полезен, но заражённый ноутбук перед ним не становится чистым. MFA снижает часть риска захвата входа, но не отменяет похищение уже действующей сессии или неверно выданные права. Нужно защищать всю цепочку, включая гипервизор, BMC, хранилище, backup-консоль и административные API.
Подход к доверию источнику описан в Microsoft: Developing a privileged access strategy. В нашем кейсе он превращается в проверку: можно ли с обычной пользовательской станции непосредственно управлять репозиторием или гипервизором? Если да, разделение аккаунтов ещё не завершило работу.
# On the authorized local server, before compromise. Read-only.
Get-NetTCPConnection -State Listen |
    Sort-Object LocalPort |
    Select-Object LocalAddress,LocalPort,OwningProcess
Get-NetFirewallProfile |
    Select-Object Name,Enabled,DefaultInboundAction,DefaultOutboundAction
Get-NetFirewallRule -PolicyStore ActiveStore -Enabled True -Direction Inbound |
    Select-Object DisplayName,Profile,Action
# Rules alone do not establish end-to-end reachability or source restrictions.
# Review address/port filters and upstream controls separately.
Эти команды читают локальные настройки. Разрешение в firewall не доказывает всю сетевую достижимость, а отсутствие порта на одном узле не исключает другое API. Проверка включает source restrictions, сетевые устройства и фактическую матрицу доступов.
7. Сегментация защищает пути, а не красивые названия VLAN
В новой схеме отдельно находятся пользовательские устройства, серверные услуги, управление, backup и будущая recovery-среда. Но правило «между VLAN разрешить всё» оставляет многие исходные пути. Сначала описываем потоки по документации установленного продукта: источник, назначение, порт, направление, назначение соединения.
Backup не обязательно «только тянет» данные: продукты используют разные агенты, control connections и data mover. Направление нельзя выдумывать ради красивой схемы. Согласованные правила сначала испытывают на ограниченной группе, наблюдают задачу backup и восстановление, затем расширяют.
Особое внимание — к путям, которые уничтожают изоляцию: BMC и гипервизор из пользовательской сети, репозиторий как обычная SMB-папка, management VPN с доступом везде, общий storage-admin. Другой subnet не мешает атакующему с правами гипервизора подключить диск или изменить виртуальный коммутатор.
Итог проверки — не «пинг запрещён», а отсутствие определённого опасного управления с конкретного источника при сохранённой полезной работе. Изменения маршрутов и ACL требуют backup конфигурации и отката: безопасность, внезапно остановившая backup, ослабила восстановление.
8. Копия, которую нельзя удалить: что именно означает immutable
В нашей исходной схеме архив — обычные файлы на доступном разделе. Мы добавляем защищённое хранение с неизменяемым сроком и отдельную копию в другом отказном домене. Это могут быть поддерживаемый hardened repository, объектное хранилище с retention или offline-носитель. Выбор зависит от продукта, бюджета, объёма и сценария, а не от модного слова.
Неизменяемость должна защищать конкретные объекты на конкретный срок. Проверяем версии, режим retention, право обхода, возможность менять будущую политику и момент истечения. В Amazon S3 governance и compliance различаются по возможностям обхода; Object Lock работает с версиями объектов. Delete marker может скрыть текущий объект, не уничтожив защищённую версию. Это надо уметь распознавать при восстановлении. Документация S3 Object Lock.
В Linux-репозитории не обещаем защиты от любого root, гипервизора или физического уничтожения дисков. Для Veeam hardened repository предусмотрены immutability и single-use credentials, но поддерживаемые требования зависят от версии. Его документация не заменяет проверку окружающего управления: Veeam Hardened Repository.
Offline-копия независима только когда она действительно отключена и правильно хранится. Второй диск в том же работающем сервере — не offline. Любой механизм также нуждается в доступных ключах и способности прочитать данные после потери исходного control plane.
9. Retention рассчитывают против времени незаметного присутствия
Атакующий может попасть в сеть раньше обнаруженного шифрования. Поэтому самая свежая копия не обязательно доверенная. Если история короткая, а злоумышленник успел ждать её ротации, защищённая цепочка может содержать только уже скомпрометированные состояния.
В кейсе задаём несколько горизонтов восстановления и рассчитываем стоимость. Не назначаем всем компаниям одинаковые 30 или 90 дней. Учитываем задержку обнаружения, размер изменений, требования бизнеса, срок ключей и запас вместимости. Много incremental-файлов без необходимого full не образуют полезную независимую копию.
Ещё один сценарий — остановка будущего backup. Старые точки пережили удаление, но новые не появляются; затем истекает retention. Поэтому мониторинг следит за возрастом последней успешной защищённой точки, фактом второй копии и сроком её удержания. Зелёный job на первой площадке не подтверждает завершение copy job на второй.
Не испытывайте удаление реальных защищённых архивов. Для проверки прав создают отдельный согласованный тестовый объект с известным retention и контролируемыми ролями. Результат refusal должен быть связан с причиной запрета, а не со случайной ошибкой сети.
10. Ключи: архив может пережить атаку и остаться навсегда закрытым
Следующий вопрос директору неприятнее: «Если сервер backup исчезнет, чем мы расшифруем файлы?» Пароль «он где-то в консоли» не годится. Нужны необходимые пароли и ключи, история их смены, поддерживаемый механизм восстановления и независимое хранение.
Не обязательно печатать все секреты на бумаге. Нужно выбрать защищённый способ аварийной выдачи, доступный при отказе обычного каталога и корпоративной почты. Ограничить круг доступа, учитывать использование и регулярно проверять процедуру. Точные секреты не включаются в общую документацию, скриншоты и incident-пакеты.
Сохраняют также конфигурацию backup-системы, сертификаты и сведения о KMS, если они нужны продукту. Поддерживаемый импорт копии и восстановление конфигурации проверяют отдельно. Для Veeam см. шифрование configuration backup и расшифрование резервных копий. Универсального обещания «без пароля всё равно восстановим» нет.
Разделение места хранения архива и ключа уменьшает часть риска, но увеличивает требования к доступности обоих. Забытый аварийный ключ — такая же реальная причина простоя, как уничтоженный backup.
11. Аварийный доступ должен пережить исчезновение домена
На тренировке объявляем AD и привычную VPN-аутентификацию недоступными. Оператор открывает recovery-инструкцию — и не может войти в систему управления. Все аккаунты доменные, секреты в корпоративном vault, MFA привязан к потерянному телефону. Формально инфраструктура зарезервирована, практически путь к ней замкнут.
Для необходимых компонентов предусматривают поддерживаемый независимый доступ: консоль, локальные аварийные записи, средства восстановления ключей, необходимые факторы и связь. Это не разрешение поставить один общий пароль без контроля. Break-glass ограничивают, охраняют, учитывают использование и проверяют по расписанию.
Аварийная инструкция имеет доступную offline-копию. В ней — расположение, последовательность, ответственные, версии и ссылки на защищённое хранение секретов, но не все пароли открытым текстом. Дежурный должен суметь найти носитель и запустить процедуру без звонка единственному автору.
Проверяют и физическую сторону: где консоль, работает ли независимый канал, кто имеет право войти в помещение, доступны ли установочные файлы. Слово «есть» заменяют временем до фактического получения доступа.
12. Журналы нужны до шифрования, а не только после
Журналы помогают определить, когда возникла компрометация и какие точки восстановления заслуживают доверия. Если они хранятся только на зашифрованных узлах, самая важная часть истории исчезает вместе с ними. Поэтому выбранные события отправляют на защищённый коллектор и, где требуется, сохраняют независимо.
Собирают не всё подряд, а доказательства: административные входы, изменения backup-политики, удаления, действия над ключами, гипервизором и сетевым управлением. Проверяют синхронизацию времени, доставку, retention и право очистки. Отправка на обычный сервер с теми же общими администраторами может лишь переместить точку уничтожения.
# On an already configured Windows Event Collector. Read-only.
Get-Service Wecsvc
wecutil es
$Start = (Get-Date).AddMinutes(-30)
try {
    Get-WinEvent -FilterHashtable @{
        LogName='ForwardedEvents'; StartTime=$Start
    } -MaxEvents 30 -ErrorAction Stop |
        Select-Object TimeCreated,MachineName,Id,ProviderName,RecordId
} catch {
    Write-Warning $_.Exception.Message
}
# A running collector is not proof that every source is forwarding.
Windows Event Forwarding — механизм доставки выбранных событий, не магическая защита коллектора: Microsoft: WEF for intrusion detection. Работающая служба не подтверждает доставку со всех источников. Нужен известный безопасный тестовый event и проверка его получения с корректным источником и временем.
В реальном инциденте сохраняют доказательства и согласуют containment с ответственными. Массовая перезагрузка или очистка «подозрительных файлов» до фиксации может уничтожить информацию и осложнить расследование.
13. Чистая среда начинается не с запуска вчерашней ВМ
Recovery-среда — отдельная доверенная площадка с контролируемым управлением. Ей нужен источник доверенных образов, сетевые устройства или настройки, вычислительные ресурсы, storage, DNS bootstrap и журнал действий. Подготовка этих элементов входит в время восстановления.
Восстановленные гости первоначально не имеют пути в заражённую сеть. Проверяют не только виртуальный switch, но и gateway, VPN, bridge, второй адаптер, DNS forwarder и административный ноутбук. Соединение «на минутку, чтобы забрать конфигурацию» способно вернуть старый путь атаки.
Отключают или перенаправляют побочные действия по отдельному плану: почту, банковский обмен, webhook, задания, очереди, синхронизацию с партнёрами. Учебная копия приложения с теми же идентификаторами может отправить настоящие уведомления или повторить документы. Изоляция должна охватывать внешние эффекты, а не только внутренние IP.
Нельзя объявить среду чистой только по отсутствию антивирусных находок. Нужны доверенный источник компонентов, ограниченные пути, проверенные идентичности и анализ выбранных данных. Антивирус — один сигнал, не сертификат отсутствия атакующего.
14. Выбор точки: доступная копия не равна доверенной
Составляем временную шкалу: ранние подозрительные входы, изменения прав, отключение защиты, остановка копирования, начало шифрования. Самое раннее известное событие не обязательно первое событие атаки. Граница доверия может оставаться неопределённой, и это нужно явно сообщить бизнесу.
Для каждой candidate-точки проверяют доступность, цепочку, расшифрование, восстановление и признаки компрометации. Хеш подтверждает совпадение байтов с доверенным эталоном, но не отсутствие вредоносного содержимого. Эталон, созданный на уже захваченном сервере, не даёт независимого доверия.
# On a trusted recovery workstation. Replace the approved manifest path.
# CSV fields: Path,SHA256. Only approved local artifact paths are accepted.
$Manifest = 'E:\RecoveryKit\manifest.csv'
$Rows = Import-Csv -LiteralPath $Manifest -ErrorAction Stop
foreach ($row in $Rows) {
    try {
        $actual = (Get-FileHash -LiteralPath $row.Path -Algorithm SHA256 -ErrorAction Stop).Hash
        [pscustomobject]@{
            Path=$row.Path
            Result=$(if ($actual -eq $row.SHA256) {'Match'} else {'Mismatch'})
            Error=$null
        }
    } catch {
        [pscustomobject]@{Path=$row.Path;Result='ReadFailed';Error=$_.Exception.Message}
    }
}
# The manifest must itself come from a trusted source.
# Matching hashes prove byte agreement, NOT absence of malware.
Этот пример предназначен для небольшого заранее подготовленного recovery-kit: инструкции, утверждённые установочные пакеты, экспортированные конфигурации. Не хешируйте всю многотерабайтную копию в первые минуты без расчёта нагрузки. CSV и его пути тоже должны поступить из доверенного источника, а не из случайного файла атакованного сервера.
Если безопасность последней копии не установлена, честный ответ — «недостаточно данных». Решение о более старой точке и потере изменений принимается с владельцем данных; администратор не скрывает этот компромисс за зелёным значком.
15. Порядок восстановления: DNS и AD нельзя разложить на простые коробки
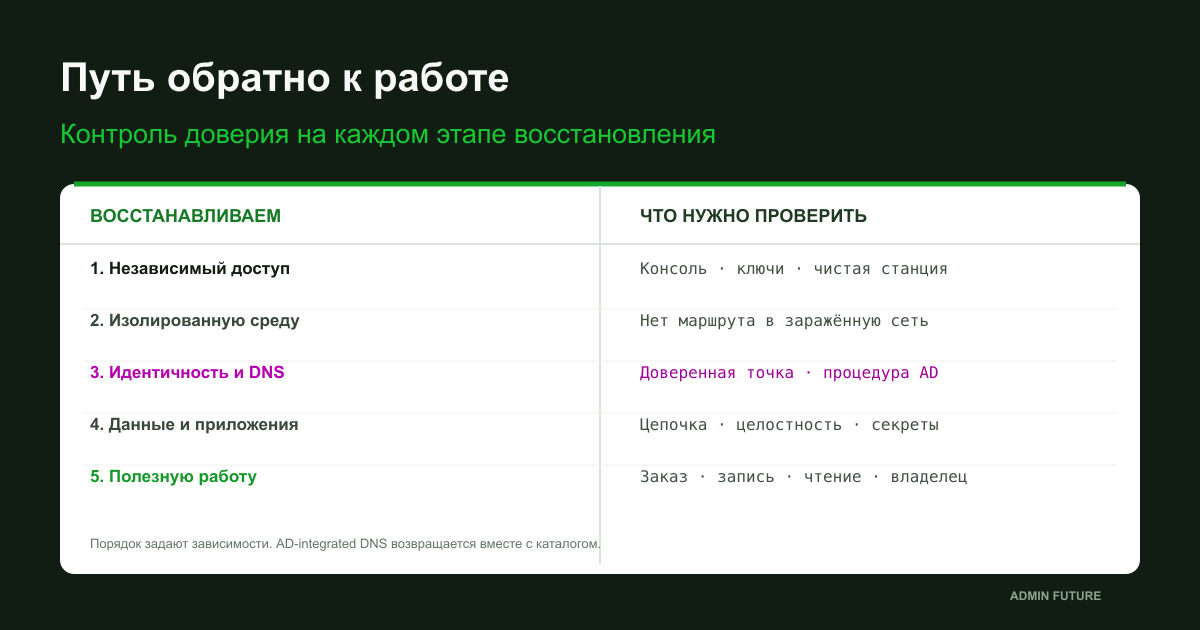
Сначала получают независимое управление и базовую connectivity recovery-среды. Затем возвращают необходимые функции идентичности и разрешения имён по выбранной процедуре. Потом — данные, приложения и клиенты. Но фраза «сначала DNS, потом AD» слишком груба: AD-integrated DNS возвращается вместе с каталогом, а bootstrap-доступ может потребовать локальные записи или отдельный resolver.
После компрометации каталога нельзя просто запустить все вчерашние DC и соединить их со старой production-сетью. Нужны доверенная точка, изоляция, поддерживаемая forest-recovery процедура, проверка полномочий и план смены скомпрометированных секретов. Конкретные действия зависят от леса и версии, а не от универсального скрипта.
Microsoft отдельно описывает восстановление леса в изоляции и выбор резервных копий: AD Forest Recovery: Determine how to recover. Здесь мы строим архитектуру готовности, не сокращаем этот регламент до нескольких команд.
Исторические пароли, DSRM и другие необходимые recovery-материалы подготавливают заранее и хранят защищённо. Сброс важных ключей и удаление старых DC — изменения с последствиями; их не выполняют наугад ради ускорения. При недостаточной уверенности привлекают специалиста по восстановлению идентичности.
16. База восстановилась — а приложение ещё не готово
Для SQL проверяют модель восстановления и совместимость full, differential и log backups. Последний файл журнала сам по себе не означает полный путь к нужной точке. История в msdb помогает реконструировать задачи, но не подтверждает существование файлов на независимой площадке.
-- Run with authorized access on the selected SQL instance.
-- Catalog/history evidence only. No restore or database changes.
SELECT name, recovery_model_desc, state_desc
FROM sys.databases
ORDER BY name;

SELECT TOP (40)
    database_name, type, backup_start_date, backup_finish_date,
    is_copy_only, has_backup_checksums, first_lsn, last_lsn,
    database_backup_lsn
FROM msdb.dbo.backupset
ORDER BY backup_finish_date DESC;
-- History does not prove the files still exist, decrypt or restore.
-- Full/differential/log compatibility requires a separate chain check.
Проверка читаемости backup полезна, но не заменяет реальный restore. RESTORE VERIFYONLY не проверяет структуру всех данных так, как работа восстановленной базы и отдельные проверки целостности: Microsoft: RESTORE VERIFYONLY. Тяжёлые проверки планируют по объёму и ресурсам, а не запускают без ограничений на работающей production-базе.
После восстановления нужны логины, сервисные identities, конфигурация приложения, сертификаты и лицензии. Возвращать старые секреты без оценки компрометации опасно; менять их без обновления потребителей — значит получить новую аварию. Поэтому ведут таблицу потребителей и согласованную последовательность ротации.
Отдельная ловушка — несогласованность базы и файлов. Запись о документе может существовать, а его вложение отсутствовать. Приложение загружается, но полезная операция повреждена. Для таких услуг заранее определяют согласованные точки и приёмочные проверки.
17. Учебная авария начинается с запрета на привычные костыли
В согласованной тренировке объявляем: основная площадка недоступна, доменная аутентификация недоступна, привычный backup-сервер использовать нельзя. Реальные production-системы не выключаем и ничего не шифруем. Проверяем восстановление в подготовленном изолированном контуре из доступных разрешённых копий.
Назначаем руководителя упражнения, технического исполнителя, наблюдателя и владельца услуги. Фиксируем допустимые действия, внешние эффекты, тестовые данные и критерии остановки. Если копия случайно получила путь в production или начала настоящий обмен, упражнение останавливают по плану.
Начинается время. Оператор получает аварийный доступ, находит материалы, импортирует доступную цепочку поддерживаемым способом, возвращает зависимости. Наблюдатель записывает потраченное время и обходы. Подсказка автора тоже учитывается: процедура, которая работает только с ним рядом, ещё не передана команде.
Самая полезная часть — не эффектная демонстрация запуска. Это список разрывов, найденных без настоящей катастрофы: недоступная лицензия, забытый ключ, неверный адрес, незадокументированная задача.
18. Приёмка: создайте заказ и прочитайте его другим пользователем
Сначала проверяем технические зависимости в recovery-контуре. Значения примера намеренно документационные; их заменяют подтверждёнными адресами именно изолированной среды. Случайно направить тест на production — значит проверить другую систему и иногда создать побочный эффект.
# Only inside the authorized isolated recovery environment.
# Replace names, IP and database port. Do not probe production by mistake.
$RecoveryDns = '192.0.2.53' # Documentation address; replace before running.
$AppName = 'app.recovery.example.net'
$DbName = 'sql.recovery.example.net'
$DbPort = 1433 # Replace if the instance uses another endpoint.
Resolve-DnsName -Name $AppName -Server $RecoveryDns -ErrorAction Stop
Resolve-DnsName -Name $DbName -Server $RecoveryDns -ErrorAction Stop
Test-NetConnection -ComputerName $DbName -Port $DbPort
# DNS resolution and TCP access do not prove successful authentication or SQL work.
# The service owner must execute the approved business acceptance operation.
Потом владелец услуги выполняет утверждённую операцию: войти тестовой записью, открыть нужный набор данных, создать заказ, сохранить, прочитать с другого рабочего места, сформировать результат без внешней отправки. Проверяются ACL, запись в базу, файлы и взаимосвязанные части.
«Порт открыт» подтверждает лишь TCP-доступ, а не корректную авторизацию или запись. «ВМ загрузилась» подтверждает ещё меньше. Бизнес-приёмка должна иметь ожидаемый результат и идентификатор тестовой операции, чтобы её можно было повторить.
В нашей вымышленной первой тренировке запускается ВМ, но создание документа ломается из-за отсутствующего лицензионного компонента. Это не успешное восстановление. После устранения зависимости повторяют всю цепочку, а не только последнюю кнопку. Числа времени публикуют как результаты именно упражнения, не как гарантии для любой аварии.
19. Возврат в production — отдельное решение о доверии
Работающая recovery-среда не получает автоматически право соединиться со старой сетью. Нужны containment, устранение известного входа, обновлённые секреты, проверка административного пути, рабочая защита и наблюдение. При существенной компрометации часть систем разумнее развернуть заново из доверенных компонентов, чем возвращать целиком старые образы.
Данные и исполняемая среда оцениваются раздельно. Можно восстановить нужные документы в новую систему, но всё равно проверять макросы, задания и другие активные компоненты. Антивирусное сканирование не даёт основания обещать абсолютную чистоту.
Возврат выполняют по этапам с владельцами, контрольными точками и откатом. Проверяют очереди и повторные отправки. Переключение адресов, DNS, маршрутов и identities согласуют, чтобы не оставить два конкурирующих приложения или источник повторной записи.
И есть проблема, которую restore не решает: украденные данные. Восстановленный сервис не отменяет возможную утечку. Организация отдельно оценивает масштабы, обязательства и необходимость уведомлений с ответственными специалистами, не подменяя расследование технической приёмкой.
20. Бюджет: сначала разорвите самый короткий путь к уничтожению
Компания не обязана купить всё сразу. Первый этап — карта услуг, список копий, ключи и доказанный restore малого критичного набора. Второй — устранение общего административного пути, защищённая история и независимый доступ. Третий — полноценная recovery-площадка, расширенная журнализация и повторяемые упражнения. Очерёдность уточняют по обнаруженным рискам.
Нельзя откладывать все меры до покупки идеальной системы. Но нельзя и утверждать, что одна подписка на immutable storage завершила проект. В бюджет входят трафик, чтение и возврат данных, ёмкость retention, ключи, отдельное управление, время сотрудников и регулярные проверки.
Для малого бизнеса иногда достаточно скромной, но реально независимой копии и подготовленного пути восстановления. Для более строгого RTO требуется больше ресурсов. Выбор подтверждается измерением, а не количеством маркетинговых обещаний. Недостаточно данных о нагрузке — недостаточно оснований обещать четырёхчасовое восстановление.
21. Что теперь ответить директору
Вместо «всё зелёное» администратор приносит короткий отчёт: какие услуги восстанавливались, из какой точки, что переживает захват production-учётной записи, где сохраняются ключи, сколько заняла проверка и какие ограничения остались. В нём нет секретов и выдуманного нулевого риска.
Каждое прежнее обещание получает свидетельство. Копии существуют — их прочитали и восстановили. Retention защищает — это проверено на согласованном тестовом объекте. Доступ независим — им воспользовались без обычного домена. Журналы сохраняются — событие дошло и доступно. Компания работает — владелец услуги принял полезную операцию.
Потом инфраструктура меняется: добавляется приложение, сотрудник, ключ, VLAN, новая версия backup. Поэтому восстановление — не разовый проект. Карту зависимостей и процедуру пересматривают после существенных изменений; упражнение повторяют по принятому графику. Накопленные незаметные изменения способны сломать вчерашний успешный план.
Директор снова спрашивает: «Бэкапы ведь есть?» Теперь ответ другой: «Есть копии и проверенный путь восстановления критичной работы. Вот что он выдерживает, вот сколько заняло испытание, а вот что мы пока не можем гарантировать». Это не абсолютная безопасность. Это управляемая способность компании вернуться к работе.
Источники и границы применения
Основы подготовки и восстановления: CISA #StopRansomware Guide и NIST SP 1800-11: Data Integrity. Дополнительно: Microsoft privileged access strategy, AD Forest Recovery Guide, S3 Object Lock, Veeam Hardened Repository и ссылки в соответствующих разделах.
Учебные цели, схема и эпизоды не являются фактами вашей инфраструктуры. Требования продуктов проверяют по установленной версии. Изменение retention, ACL, маршрутов, ключей, DC и production storage, а также реальное отказное испытание требуют отдельного плана, оценки риска и согласования. В статье нет инструкций по запуску вредоносного ПО или атаке на чужие системы.