В этой статье
Отчёт открыт, бухгалтерия ждёт, сервер почти свободен
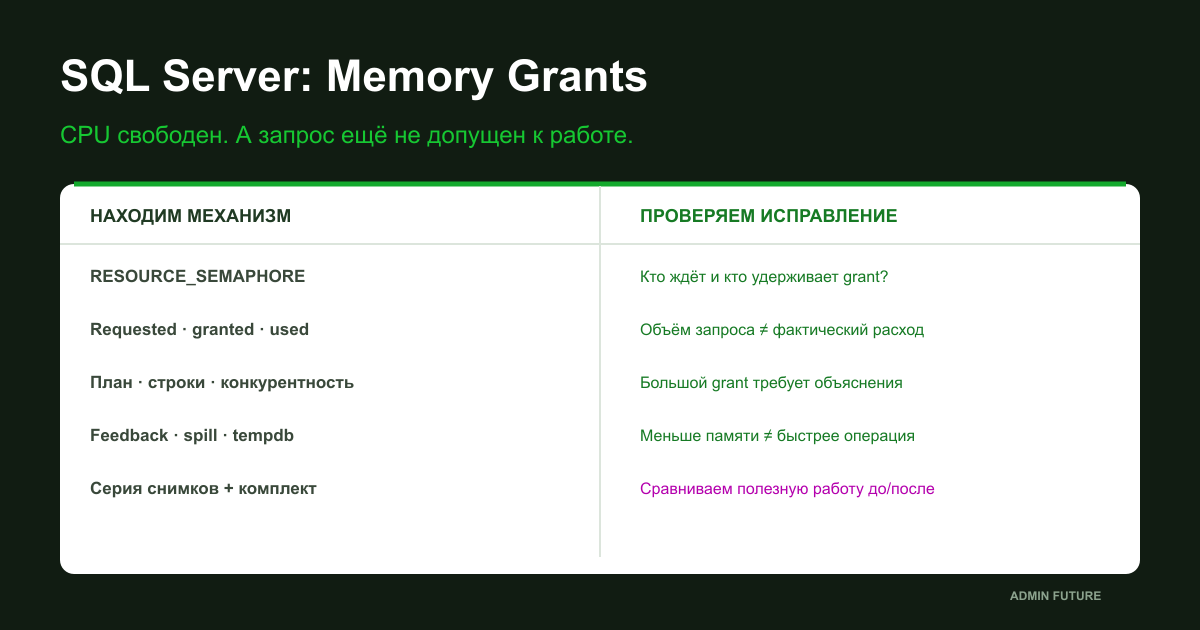
Один тяжёлый отчёт запускается — и соседние операции 1С начинают ждать. Процессоры свободны, длинной блокировки нет. Проверим, не закончилась ли память, которую SQL Server разрешает выдавать запросам.
Привет, коллеги. Меня зовут Максим, я системный администратор. Представим утро в бухгалтерии: сотрудник строит отчёт за год, второй открывает другой отчёт, третий повторяет запуск, решив, что первый раз не нажал кнопку. Через несколько минут поступает привычная заявка: «1С зависла». На сервере нет ожидаемых ста процентов CPU, свободная память Windows выглядит успокаивающе, диски не показывают очевидной катастрофы.
Первое желание — добавить RAM или перезапустить SQL Server. Но перезапуск одновременно завершит работу пользователей, очистит часть диагностических свидетельств и временно разнесёт запросы во времени. После него можно получить быстрое приложение и совершенно неправильный вывод о причине.
Мой тезис: запросу может не хватать разрешения на рабочую память, даже когда процессоры способны выполнять его прямо сейчас. Пока он ждёт memory grant, CPU не обязан расти. Мы будем расследовать не общую занятость машины, а очередь допуска к выполнению.
В этой статье пройдём четыре уровня: подтвердим механизм ожидания, найдём получателей и ожидающих, проверим обоснованность объёма, затем сравним исправления под одинаковой конкурентной нагрузкой. Только практика, SQL-запросы и команды — с объяснением механики и границ каждого вывода.
Проблема: четыре разных состояния под словом «память»
Прежде чем строить защиту, нужно определить, что именно мы называем нехваткой памяти. В нашем сценарии легко перепутать четыре состояния.
- Давление на память ОС. Windows и соседние процессы конкурируют за физическую RAM. Здесь важны системные сигналы, память процессов, настройки виртуальной машины и реальная конфигурация экземпляра.
- Ожидание grant. Запрос просит рабочую область для выполнения, но пока не получил её. Типичный диагностический след — RESOURCE_SEMAPHORE и ожидающая строка в DMV grants.
- Недостаточный grant и spill. Запрос уже выполняется, но часть сортировки или hash-операции не помещается в выделенную область и использует tempdb. Это не то же состояние, что ожидание перед получением grant.
- Память компиляции. Запрос ожидает ресурсы оптимизатора. RESOURCE_SEMAPHORE_QUERY_COMPILE имеет другой смысл, чем RESOURCE_SEMAPHORE.
Наблюдения могут сочетаться. Один отчёт удерживает большой grant, соседний ждёт, третий уже получил меньше желаемого и пишет в tempdb. Если назвать всё «не хватает оперативки», мы потеряем причинную последовательность. Справочник ожиданий Microsoft помогает отделить названия механизмов от бытового описания симптома.
Результат первого уровня должен быть узким: в момент жалобы конкретные запросы ожидали именно память выполнения. Это ещё не ответ на вопрос, кто создал очередь и какое изменение будет полезным.
Как SQL Server выдаёт рабочую область
Memory grant — выделение рабочей памяти для определённых операций плана. Сортировка должна где-то держать сортируемые данные, hash join — свою хеш-структуру. Наличие grant не зависит только от слова ORDER BY в тексте: важны фактические операторы выбранного плана. И наоборот, упорядоченный индекс иногда позволяет получить нужный порядок без отдельной сортировки.
SQL Server оценивает потребность, запрашивает область и выдаёт её с учётом доступных ресурсов. Важно различать минимально необходимый объём, запрошенный, предоставленный и использованный. Предоставление большой области не означает, что столько же физических страниц немедленно заняты полезными данными. Но обязательство по grant влияет на возможность допустить другую работу. Механизм memory grants.
Для мысленного опыта возьмём условный бюджет 100 единиц. Отчёт А получил 65, отчёт Б — 25, новому отчёту В нужно минимум 20. Оставшихся 10 недостаточно: В ждёт, хотя его будущая работа могла бы загрузить свободное ядро. Это иллюстрация арифметики, а не результат измерений и не буквальный алгоритм планировщика SQL Server.
Не предполагаем, что очередь строго FIFO или что все запросы одного экземпляра пользуются одной общей корзиной. Существуют resource pools и разные семaphores. Поэтому в диагностике связываем pool_id и resource_semaphore_id, не только номер очереди. Читателю не нужно угадывать внутренний порядок — достаточно увидеть ожидающую работу и состояние её конкретного ресурса.
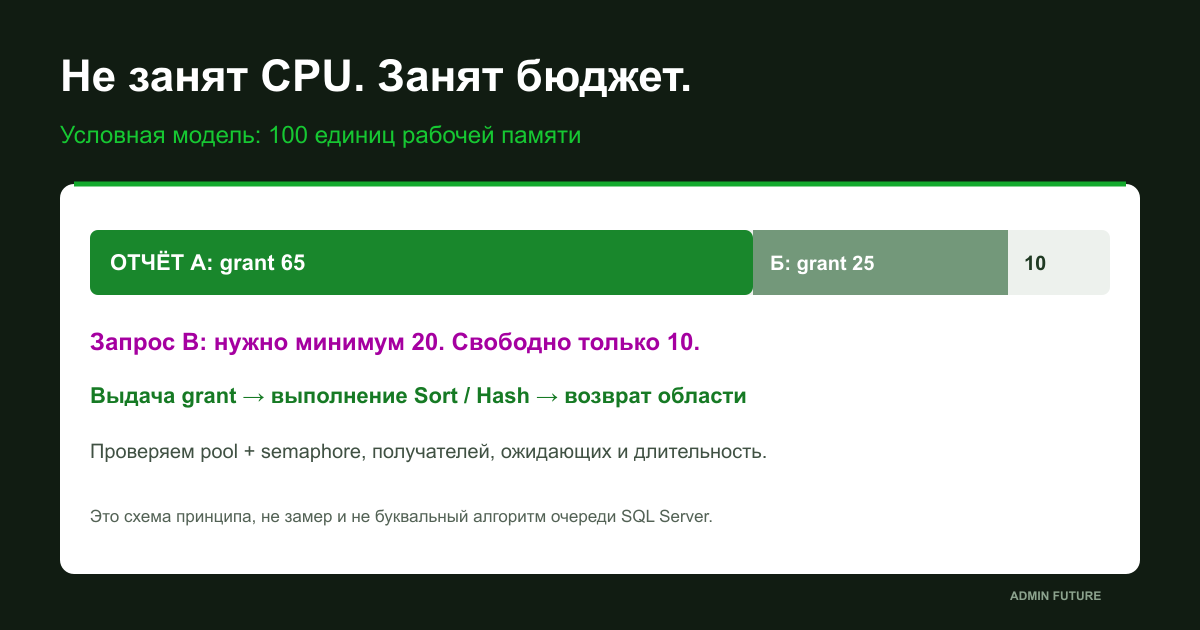
После этого рисунка вопрос меняется: не «почему SQL не использует свободную RAM?», а «какой бюджет ограничен, кто его удерживает и соответствует ли это выполняемой работе?».
Границы руководства и подготовка без изменения настроек
Основной ориентир — SQL Server 2019/2022 на Windows. Возможности SQL Server 2025 и других выпусков сверяются отдельно. Для каждого экземпляра важны точная сборка, редакция, уровень совместимости базы и поддержка конкретной версии платформой 1С. Эта статья не объявляет любой новый SQL Server автоматически поддержанным для вашей базы.
Запросы диагностического комплекта читают DMV; они не меняют max server memory, не очищают кэш и не завершают пользовательские сеансы. Но чтение тоже требует ресурсов и достаточных прав. На SQL Server 2019 для соответствующих серверных DMV обычно нужен VIEW SERVER STATE; на SQL Server 2022 и новее проверяем VIEW SERVER PERFORMANCE STATE по документации каждой используемой DMV. Не выдаём sysadmin просто для удобства сбора.
-- READ ONLY. SQL Server 2019/2022; run on the intended instance.
SET NOCOUNT ON;
SELECT SYSUTCDATETIME() AS captured_utc,
       CONVERT(nvarchar(128),SERVERPROPERTY('ServerName')) AS server_name,
       CONVERT(nvarchar(128),SERVERPROPERTY('ProductVersion')) AS product_version,
       CONVERT(nvarchar(128),SERVERPROPERTY('Edition')) AS edition;
SELECT name,compatibility_level FROM sys.databases;
SELECT name,value,value_in_use FROM sys.configurations
WHERE name IN ('min server memory (MB)','max server memory (MB)',
               'min memory per query (KB)','query wait (s)','max degree of parallelism');
SELECT total_physical_memory_kb,available_physical_memory_kb,
       system_low_memory_signal_state,system_high_memory_signal_state,
       system_memory_state_desc FROM sys.dm_os_sys_memory;
SELECT physical_memory_in_use_kb,locked_page_allocations_kb,
       process_physical_memory_low,process_virtual_memory_low
FROM sys.dm_os_process_memory;
SELECT sqlserver_start_time FROM sys.dm_os_sys_info;
Запишите экземпляр и время жалобы до обсуждения исправлений. На одном хосте могут работать несколько SQL Server, rphost, backup-агент и другие нагрузки. Их нельзя считать одной общей базой памяти или переносить настройки с соседнего клиента.
Сигнал available_physical_memory_kb относится к ОС, process_physical_memory_low — к процессу, available_memory_kb в semaphore — к определённой рабочей области. Одинаковое слово available не делает показатели взаимозаменяемыми. max server memory также не является обещанием жёстко ограничить абсолютно все выделения процесса; планировать запас ОС и другим компонентам всё равно нужно. Настройки памяти экземпляра.
Команды сверены с документацией и статически проверены, но в ходе подготовки статьи не выполнялись на живом SQL Server. Здесь нет выдуманных замеров или гарантированного лабораторного результата. Ожидаемые признаки ниже нужно воспроизвести на своей согласованной тестовой конфигурации.
Уровень 1. Ловим получателей и ожидающих одним снимком
Решение в лоб — посмотреть историческую сумму RESOURCE_SEMAPHORE и объявить причину найденной. Это накопленный показатель, который мог расти вчера. Во время текущей жалобы нужны живые запросы.
-- READ ONLY. No ORDER BY/aggregation/XML plan collection in this live query.
SET NOCOUNT ON;
SELECT SYSUTCDATETIME() AS captured_utc,
       g.session_id,g.request_id,r.database_id,DB_NAME(r.database_id) AS database_name,
       s.host_name,s.program_name,s.login_name,
       r.status,r.wait_type,r.wait_time AS request_wait_ms,r.blocking_session_id,
       g.request_time,g.grant_time,g.wait_time_ms AS grant_wait_ms,g.timeout_sec,
       g.requested_memory_kb,g.required_memory_kb,g.granted_memory_kb,
       g.used_memory_kb,g.max_used_memory_kb,g.dop,
       g.pool_id,g.group_id,g.resource_semaphore_id,g.queue_id,g.wait_order,
       g.is_next_candidate,g.sql_handle,g.plan_handle,
       r.statement_start_offset,r.statement_end_offset,t.text AS batch_text
FROM sys.dm_exec_query_memory_grants AS g
LEFT JOIN sys.dm_exec_requests AS r ON r.session_id=g.session_id AND r.request_id=g.request_id
LEFT JOIN sys.dm_exec_sessions AS s ON s.session_id=g.session_id
OUTER APPLY sys.dm_exec_sql_text(g.sql_handle) AS t
WHERE g.session_id<>@@SPID;

-- Requests waiting for execution memory and compilation memory are different.
SELECT SYSUTCDATETIME() AS captured_utc,session_id,request_id,database_id,
       wait_type,wait_time,blocking_session_id,granted_query_memory
FROM sys.dm_exec_requests
WHERE session_id<>@@SPID
  AND wait_type IN ('RESOURCE_SEMAPHORE','RESOURCE_SEMAPHORE_QUERY_COMPILE');
-- granted_query_memory in the second result is measured in 8-KB pages, NOT KB.
Сначала смотрим grant_time: NULL означает, что выдача ещё не произошла. Рядом — requested_memory_kb, required_memory_kb, granted_memory_kb и время ожидания. Затем находим запросы, которые уже получили grant. Нельзя расследовать только жертв и не смотреть удерживающих ресурс.
В нашем сюжете ожидающим может оказаться небольшой отчёт, а самый большой grant — у другого сеанса, который пользователь не считает проблемным. Это пока кандидат на влияние, не виновный по одному числу. Оценим потребность и длительность удержания.
Как это работает: строки grants связаны с requests по session_id и request_id, а с сеансами — по session_id. Пул соединений 1С не даёт права автоматически назвать SQL session конкретным бухгалтером. HostName и ProgramName — сведения клиента, не удостоверение личности. Связываем время, запрос, информационную базу и технологический журнал 1С по согласованному сбору.
Полный batch_text помогает расследованию, но может содержать бизнес-данные и литералы. Храним выгрузку в закрытом каталоге, перед передачей обезличиваем. При анализе текущего оператора используем statement_start_offset/statement_end_offset; это смещения в байтах Unicode, а не готовые индексы символов.
Полный смысл полей описан в DMV memory grants. Запросы без потребности в grant там отсутствуют: пустой результат не доказывает здоровье всего SQL Server.
Уровень 2. Находим ограниченный бюджет
Теперь проверим, что видит сама система выдачи памяти. Свободные гигабайты Windows оставляем рядом как контекст, но ответ ищем в том resource pool и semaphore, к которому относится ожидающий запрос.
-- READ ONLY. Pair pool_id AND resource_semaphore_id; semaphore ID alone is not unique.
SET NOCOUNT ON;
SELECT SYSUTCDATETIME() AS captured_utc,pool_id,resource_semaphore_id,
       target_memory_kb,max_target_memory_kb,total_memory_kb,available_memory_kb,
       granted_memory_kb,used_memory_kb,grantee_count,waiter_count,
       timeout_error_count,forced_grant_count
FROM sys.dm_exec_query_resource_semaphores;
SELECT SYSUTCDATETIME() AS captured_utc,object_name,counter_name,instance_name,
       cntr_value,cntr_type
FROM sys.dm_os_performance_counters
WHERE object_name LIKE N'%:Memory Manager%'
  AND counter_name IN (N'Memory Grants Pending',N'Memory Grants Outstanding',
                       N'Granted Workspace Memory (KB)',N'Maximum Workspace Memory (KB)',
                       N'Target Server Memory (KB)',N'Total Server Memory (KB)');
SELECT SYSUTCDATETIME() AS captured_utc,wait_type,waiting_tasks_count,
       wait_time_ms,signal_wait_time_ms
FROM sys.dm_os_wait_stats
WHERE wait_type IN ('RESOURCE_SEMAPHORE','RESOURCE_SEMAPHORE_QUERY_COMPILE');
-- Wait statistics are cumulative; compare snapshots. Never clear counters to get a baseline.
Как это работает: waiter_count показывает ожидающих, grantee_count — получивших область. Available, granted и used описывают разные стороны бюджета. В диагностике сопоставляем строки по паре pool_id/resource_semaphore_id. Не складываем несовместимые значения в универсальное «свободно всего».
| Поле / показатель | Единицы | Смысл | Ловушка |
|---|---|---|---|
| requested / granted / used_memory_kb | KB | Запрос, выдача, текущий расход | Это три разных значения |
| max_used_memory_kb | KB | Пик до текущего снимка | Не обязательно итоговый пик |
| granted_query_memory в requests | Страницы 8 KB | Выделенный grant | Нельзя читать как KB |
| Pending / Outstanding | Количество | Ожидающие / получившие | Не размер памяти |
| wait_time_ms / timeout_sec | ms / s | Ожидание / timeout запроса grant | Разные единицы |
| pool_id + resource_semaphore_id | Идентификаторы | Контекст бюджета | Номер semaphore не уникален сам по себе |
Короткий всплеск Pending не равен многочасовой аварии. Снимки связываются с длительностью полезной операции и числом одновременных запросов. Накопленное wait_time_ms сравниваем разностью за один интервал; несколько параллельных ожиданий могут дать сумму больше длительности этого интервала.
SQL Server Memory Manager различает число grants и их объём. Outstanding=1 может означать как маленький запрос, так и значительного потребителя. Две тысячи свободных мегабайт ОС не объясняют доступный бюджет определённого пула. Справочник semaphores и Memory Manager counters.
На этом уровне мы уже можем сказать: в такой-то интервал очередь возникла у такого-то ресурса, одновременно выполнялись такие-то запросы, а состояние ОС было таким-то. Это пригодная для проверки модель вместо фразы «SQL почему-то мало использует память».
Серия снимков: без перезапуска и сброса счётчиков
Один кадр может попасть между двумя короткими запросами. В комплекте есть Collect-AFMemoryGrants.ps1: ограниченное число опросов, отдельные CSV по результатам, контекст экземпляра и явный признак неполного сбора при ошибке.
# Windows PowerShell 5.1. Use the reviewed script and SQL files together.
# Replace the fictional lab instance and choose a NEW private report directory.
.\Collect-AFMemoryGrants.ps1 -ServerInstance 'AF-SQL-LAB.ad.example.com' -OutputDirectory 'C:\PrivateAudit\MemoryGrants-20261026' -Samples 12 -IntervalSeconds 5
# TLS validation remains enabled; report text can contain business data.
# No SQL password, automatic permission grant or configuration change is performed.
Сборщик использует Windows integrated authentication и проверку TLS-сертификата сервера. Имя экземпляра заменяется своим. Если сертификату не доверяют или имя не совпадает, сначала приводим в порядок доверие и адрес подключения; не добавляем TrustServerCertificate=True автоматически ради запуска скрипта.
По умолчанию собираются 12 снимков с паузами пять секунд между завершёнными опросами. Это примерно минутный эпизод, но не обещание ровно минутного времени: запросы и соединение имеют собственные тайм-ауты. SQL-сборщик тоже имеет session_id; live-запрос исключает себя, а его ProgramName явно помечен AdminFuture-MemoryGrant-Collector.
Здесь намеренно нет сортировки большого результата, агрегации всех планов или автоматической выгрузки XML для каждого сеанса. Диагностический инструмент не должен сам создавать заметную очередь на исследуемый ресурс. Нужный plan_handle сохраняем, а план выбранного запроса рассматриваем отдельным точечным действием.
FAILED.txt означает неполную серию, а не отсутствие проблемы. COMPLETE.txt означает лишь успешное завершение сбора. Ни тот, ни другой файл не заменяет интерпретацию данных. Не публикуем CSV целиком: в них присутствуют SQL-тексты, имена баз и сеансов.
Уровень 3. Большой grant ещё не доказательство ошибки
Вернёмся к годовому отчёту. Он получил много памяти, а использует пока мало. Кажется, виновник найден. Но «пока» здесь важнее всего: запрос мог ещё не дойти до оператора, которому понадобится эта область.
used_memory_kb — текущее использование. max_used_memory_kb — наибольшее использование до момента снимка, не обязательно окончательный максимум. Поэтому сравниваем несколько стадий и завершившееся выполнение. Иначе оптимизацию заменит наблюдение первых миллисекунд.
-- READ ONLY. SQL Server 2019/2022 cache: completed executions still in cache only.
-- No automatic query-plan XML expansion; preserve the selected handle for targeted inspection.
SET NOCOUNT ON;
SELECT SYSUTCDATETIME() AS captured_utc,creation_time,last_execution_time,
       execution_count,query_hash,query_plan_hash,plan_handle,sql_handle,
       statement_start_offset,statement_end_offset,
       last_grant_kb,last_used_grant_kb,max_grant_kb,max_used_grant_kb,
       last_spills,total_spills,last_elapsed_time,last_worker_time
FROM sys.dm_exec_query_stats
WHERE last_execution_time>=DATEADD(minute,-15,GETDATE()) AND last_grant_kb>0;
-- last/max grant values are KB; elapsed/worker times are microseconds.
-- last_spills/total_spills count 8-KB pages, not spill events.
-- max_grant_kb and max_used_grant_kb can refer to DIFFERENT executions.
Эта DMV содержит завершённые выполнения, сведения о которых ещё находятся в кэше. Last относится к последнему выполнению; max_grant_kb и max_used_grant_kb могли прийти из разных запусков. Отношение двух максимумов нельзя выдавать за перерасход одного конкретного отчёта. После вытеснения плана часть истории исчезнет. Смысл полей query stats.
Дальше изучаем план конкретного запроса. Проверяем оценки и фактическое количество строк, ширину передаваемых данных, Sort и Hash Match, MemoryGrantInfo, предупреждения spill. Сохранённый в кэше план не становится фактическим планом завершённого запуска от одного вызова sys.dm_exec_query_plan. В production получение actual plan само требует выбранного безопасного метода и оценки накладных расходов.
-- READ ONLY, targeted cached plan, NOT an actual post-execution plan.
DECLARE @PlanHandle varbinary(64)=NULL;
-- Replace NULL above with the exact 0x... plan_handle from your reviewed capture.
IF @PlanHandle IS NULL THROW 51004,'Supply the selected captured plan handle.',1;
SELECT query_plan FROM sys.dm_exec_query_plan(@PlanHandle);
-- A NULL/absent plan can mean eviction or another availability limitation.
-- Do not request XML plans for every cached entry during an incident.
Решение в лоб — обрезать самый большой grant. Правильный вопрос: большой относительно чего? Годовой отчёт может действительно обрабатывать больше данных. Нужны размер результата, параметры, план и измеренное использование. Иногда проблема не в одном раздутом запросе, а в десяти разумных запросах, запущенных одновременно.
Spill и ожидание grant: как не вылечить одно за счёт другого
Предположим, после ограничения памяти отчёт В перестал ждать допуска. Но теперь он долго сортирует через tempdb, создаёт дополнительный I/O и удерживает ресурсы дольше. Очередь Pending стала короче, а пользователь получил ещё более медленную операцию.
Такой исход не опровергает механизм grants. Он показывает, что исправление оценили по одному индикатору. Недостаточная область и очередь выдачи — разные проявления баланса между размером и количеством одновременно выполняемой работы.
Полезно представить два края. Слишком большой относительно потребности grant может снижать конкурентность. Слишком маленький может увеличить spill и длительность выполнения. Между ними нет единого процента, который можно назначить всем отчётам компании.
Смотрим одновременно на grant wait, продолжительность запроса, CPU, logical reads, признаки spill и задержку соседних операций. Сам по себе большой объём tempdb не доказывает spill именно этого отчёта; связываем свидетельства с конкретным планом и интервалом. И не путаем это с прошлой статьёй про PAGELATCH: там расследовалась конкуренция за внутренние страницы, здесь — рабочая память выполнения.
В нашем сценарии полезное исправление должно вернуть работу бухгалтерии и сохранить допустимое время годового отчёта. Победа одного счётчика при ухудшении общего времени не считается победой.
Исправления: сначала уменьшаем потребность и конфликт нагрузки
Мой порядок действий начинается с обратимого изменения на минимальной области. Например, сотрудник случайно формирует отчёт за все годы вместо одного периода; лишние поля увеличивают ширину строки; раннее соединение размножает данные, которые затем приходится сортировать. Это проверяемые гипотезы, а не повод автоматически переписывать SQL платформы.
Для 1С изменения выполняются поддержанным способом через конфигурацию, расширение и работу разработчика. Нельзя без отдельного проекта добавлять индексы или менять структуру таблиц информационной базы вручную. Администратор устанавливает механизм и приносит конкретный запрос с параметрами и доказательствами, разработчик помогает уменьшить необходимую работу.
Проверяем оценки кардинальности и статистику именно затронутых объектов. Не запускаем обновление всей статистики WITH FULLSCAN как универсальный первый шаг в разгар рабочего дня. Даже полезная статистика может изменить планы соседних запросов, а сама операция потребляет ресурсы.
Если разумные тяжёлые отчёты сталкиваются по расписанию, рассматриваем их разнесение, очередь запуска или ограничение конкурентности на уровне приложения. Но время ожидания очереди не исчезает: его учитывают в полном времени получения результата. Переносить ожидание из SQL в невидимую очередь 1С и объявлять ускорение нельзя.
| Гипотеза | Проверка | Изменение минимальной области | Контроль риска |
|---|---|---|---|
| Лишние данные/широкая строка | Параметры и план | Поддержанное изменение отчёта | Корректность результата |
| Ошибочная оценка | Estimate vs actual, статистика | Точечная работа с причиной | Соседние планы и нагрузка |
| Слишком много разумных отчётов | Одинаковый запрос при разной конкурентности | Расписание/очередь приложения | Полное время с ожиданием |
| Слишком мал бюджет экземпляра/пула | Конфигурация, edition, другие процессы | Согласованная настройка | Запас ОС и соседних служб |
| Нужен точечный ограничитель | Стенд и план до/после | Hint только поддержанного запроса | Spill и соседние операции |
Дальше изучаем max server memory, реальный запас ОС, другие экземпляры и лимиты редакции. Увеличение памяти имеет смысл, когда показан недостаточный бюджет при обоснованной работе и допустимом резерве хоста. Увеличение одного числа без анализа соседних потребителей способно перенести аварию на Windows или rphost.
Memory grant feedback: полезная адаптация с условиями
SQL Server умеет корректировать grant повторяющегося запроса по наблюдаемой потребности. Это memory grant feedback. Но фраза «у нас новый SQL, он сам исправит» слишком широка: важны режим выполнения, версия, compatibility level и состояние Query Store.
| Механизм | Ориентир версии | Дополнительное условие |
|---|---|---|
| Batch mode feedback | SQL Server 2017+ | Compatibility 140+, применимый план |
| Row mode feedback | SQL Server 2019+ | Compatibility 150+, применимый план |
| Persistence / percentile | SQL Server 2022+ | Применимость 140+, Query Store READ_WRITE |
| Проверка действия | Actual plan / выбранные события | Флаг ON не заменяет наблюдение |
Batch mode feedback появился в SQL Server 2017 при соответствующих условиях compatibility 140+, row mode — в 2019 при 150+. SQL Server 2022 добавил persistence и percentile-механику, связанную с Query Store READ_WRITE и применимостью compatibility 140+. Наличие флага конфигурации ещё не доказывает участие механизма в конкретном запуске. Документация memory grant feedback.
-- READ ONLY. Open a connection to the intended information-base database first.
SELECT DB_NAME() AS current_database,name,compatibility_level
FROM sys.databases WHERE database_id=DB_ID();
SELECT name,value,value_for_secondary
FROM sys.database_scoped_configurations
WHERE name IN (N'BATCH_MODE_MEMORY_GRANT_FEEDBACK',N'ROW_MODE_MEMORY_GRANT_FEEDBACK',
               N'MEMORY_GRANT_FEEDBACK_PERSISTENCE',N'MEMORY_GRANT_FEEDBACK_PERCENTILE_GRANT');
SELECT actual_state_desc,desired_state_desc,readonly_reason
FROM sys.database_query_store_options;
-- An enabled setting alone does not prove feedback adjusted the selected execution.
В actual plan смотрим IsMemoryGrantFeedbackAdjusted и связанные значения. Первый запуск не может использовать опыт ещё не произошедших выполнений. Резко отличающиеся параметры и нестабильная потребность усложняют адаптацию. RECOMPILE и отсутствие подходящего повторного использования тоже требуют отдельного анализа; нельзя одновременно стирать историю плана и требовать от неё обучения.
Query Store помогает сохранить контекст и сравнить интервалы, но его агрегаты не являются точным журналом каждого клика пользователя. Здесь используется очередь рабочей памяти, хотя источником неправильного размера может оказаться оценка плана. Это не делает расследование повтором статьи о плохом плане: нам нужно объяснить влияние на соседнюю работу и конкурентность всего экземпляра.
Не меняем compatibility всей базы ради эксперимента с одним отчётом. Такое изменение способно затронуть множество планов. Сначала стенд, baseline, поддержка платформы, область пилота и план возврата.
Hints: ограничение памяти не должно становиться заклинанием
У MAX_GRANT_PERCENT и MIN_GRANT_PERCENT есть конкретная семантика, а не обещание ускорения. Верхняя граница может увеличить spill; минимальное резервирование может ухудшить допуск соседей. Процент относится к соответствующему настроенному лимиту, не к произвольной цифре свободной RAM из Диспетчера задач. В default/system pool и пользовательском pool возможны разные последствия недостатка минимально необходимой памяти. Query hints Microsoft.
В статье нет команды назначить всем запросам один процент и нет готового глобального Resource Governor classifier для production. Такие изменения требуют поддержки редакции и версии, понимания групп нагрузок и теста не только отчёта, но и соседних бизнес-операций.
Точечный hint рассматривается после объяснения механизма, когда у администратора есть возможность управлять именно этим запросом поддержанным способом. Для платформенной 1С эта возможность не подразумевается автоматически. Query Store hints в подходящих версиях также являются изменением поведения, которому нужны конкретный query_id, проверка действия и обратная операция, а не массовое назначение.
Ещё одна плохая первая реакция — KILL сеанса с большим grant. Нужно понимать владельца, текущую операцию и последствия отмены. Она может иметь транзакционные побочные эффекты, а большой grant мог принадлежать необходимому обслуживанию. Не включаем автоматическое убийство по одному порогу в диагностический сборщик.
В лаборатории ниже мы специально используем большой минимальный процент, чтобы показать конкуренцию. Это способ создать учебный симптом, не рекомендация лечить им реальную систему.
Безопасная лаборатория: две сессии и отдельный экземпляр
Внимание: опыт создаёт базу и намеренно провоцирует конкуренцию памяти. Нужен отдельный одноразовый экземпляр без баз клиентов, достаточное место для data/log/tempdb и возможность отменить свои подключения. Отдельная база на общем продуктивном экземпляре не обеспечивает изоляцию памяти.
Файл LAB-01-create.sql содержит явный переключатель @ConfirmDisposableLab=0. Только после проверки цели меняем его на 1 и создаём AFMemoryGrantLab. Уже существующая база вызывает остановку, а не перезапись. Набор создаёт до 200000 строк с широким текстовым полем; это учебные данные, не копия 1С.
-- WRITE OPERATION. DISPOSABLE INSTANCE ONLY, not a 1C/production instance.
-- Deliberate gate: review target, storage, backups and set this to 1 yourself.
DECLARE @ConfirmDisposableLab bit=0;
IF @ConfirmDisposableLab<>1 THROW 51000,'Only an approved disposable SQL instance is allowed.',1;
IF DB_ID(N'AFMemoryGrantLab') IS NOT NULL THROW 51001,'Lab database exists; do not overwrite it.',1;
EXEC(N'CREATE DATABASE [AFMemoryGrantLab];');
EXEC(N'USE [AFMemoryGrantLab];
CREATE TABLE dbo.GrantRows(id int NOT NULL PRIMARY KEY, Payload varchar(300) NOT NULL);
WITH numbers AS
(
    SELECT TOP (200000) CONVERT(int,ROW_NUMBER() OVER(ORDER BY (SELECT NULL))) AS n
    FROM sys.all_objects AS a CROSS JOIN sys.all_objects AS b
)
INSERT dbo.GrantRows(id,Payload)
SELECT n,REPLICATE(CONVERT(varchar(36),NEWID()),8) FROM numbers;
UPDATE STATISTICS dbo.GrantRows;
SELECT COUNT_BIG(*) AS rows_created FROM dbo.GrantRows;');
-- No automatic deletion. If a later statement fails, inspect the created lab DB.
Затем в двух отдельных клиентах выполняем один и тот же LAB-02-pressure.sql. В третьем — диагностические снимки. Ниже полный текст нагрузки:
-- DISPOSABLE INSTANCE ONLY. Connect explicitly to AFMemoryGrantLab.
-- Run in TWO lab clients with a 30-second CLIENT command timeout, e.g. sqlcmd -t 30.
IF DB_NAME()<>N'AFMemoryGrantLab' THROW 51002,'Wrong database.',1;
IF OBJECT_ID(N'dbo.GrantRows',N'U') IS NULL THROW 51003,'Missing lab table.',1;
SET NOCOUNT ON;
SELECT @@SPID AS lab_session_id;
DECLARE @until datetime2=DATEADD(second,20,SYSUTCDATETIME());
WHILE SYSUTCDATETIME()<@until
BEGIN
    SELECT COUNT_BIG(*) AS distinct_payloads
    FROM (SELECT Payload FROM dbo.GrantRows GROUP BY Payload) AS groupset
    OPTION(HASH GROUP,MAXDOP 1,MIN_GRANT_PERCENT=60,MAX_GRANT_PERCENT=60);
END;
-- 60% is artificial pressure, NOT a production tuning recommendation.
-- Loop time is checked BETWEEN executions; only the CLIENT timeout bounds a blocked call.
-- Depending on version, pool and plan this may wait, fail or finish too quickly.
-- Zero observed queue is a valid result: inspect the plan/grants, do not escalate on production.
Запускайте её с клиентским command timeout 30 секунд. В sqlcmd это -t 30; проверка двадцатисекундного цикла происходит между выполнениями и сама по себе не ограничивает время ожидания grant. Не путайте её с LOCK_TIMEOUT: ожидание памяти не становится ожиданием блокировки.
# DISPOSABLE SQL INSTANCE ONLY; replace the name after reviewing the lab gate.
# Run this in TWO separate clients, then collect diagnostics in a third connection.
# Existing sqlcmd installation, Windows integrated authentication, client timeout 30s.
sqlcmd -S 'AF-SQL-LAB.ad.example.com' -E -d AFMemoryGrantLab -i '.\LAB-02-pressure.sql' -t 30 -b
# After cancelling/completing your own test clients, compare WITHOUT grant hints:
sqlcmd -S 'AF-SQL-LAB.ad.example.com' -E -d AFMemoryGrantLab -i '.\LAB-03-baseline.sql' -t 30 -b
# Do not add -C to bypass certificate validation. Inspect TLS configuration if needed.
Ожидаемая иллюстрация — выданный большой grant и пересекающаяся попытка второго клиента. Но конкретный план, пул и версия могут дать иной результат: быстрое завершение, ошибку или отсутствие заметной очереди. Это фиксируется как результат опыта. Сначала изучаем фактический план и grants, не раздуваем нагрузку на рабочей инфраструктуре ради красивого скриншота.
Для возврата отменяем только свои два лабораторных клиента, подтверждаем завершение их запросов и повторяем тот же опыт с LAB-03-baseline.sql без grant hints. Экземпляр не перенастраивался, кэш не очищался. База остаётся для анализа; автоматического DROP DATABASE в комплекте нет. Снятие симптома искусственным удалением hint доказывает учебный механизм, но не эффективность такого изменения для 1С.
Уровень 4. Проверяем исправление на одинаковой работе
Вернёмся к бухгалтерии. Допустим, после анализа разработчик сузил набор данных отчёта или расписание перестало запускать несколько тяжёлых операций одновременно. Одного быстрого запуска недостаточно: он мог попасть на прогретый кэш и пустой сервер.
| Что сравнить | До | После | Условие честного сравнения |
|---|---|---|---|
| Полезная операция | Время и корректность | Время и корректность | Те же параметры/объём |
| Конкурентность | Число одновременных запусков | То же число | Учесть очередь приложения |
| Grant queue | Снимки / дельта waits | Та же серия | Тот же интервал и нагрузка |
| Цена исполнения | CPU, reads, spill | CPU, reads, spill | Не спрятать деградацию в tempdb |
| Соседние операции | Время типовых действий | Повторить те же действия | Не принимать один быстрый отчёт |
| Возврат | Прежние значения/версия | Подтверждённая обратная операция | Не подменять reboot |
Я фиксирую параметры, число одновременно работающих клиентов и полный путь получения результата. Сравниваю несколько повторов и соседние операции, а не только лучший результат. Если отчёт поменял набор данных, отдельно проверяем корректность результата: ускорение, которое потеряло необходимые строки, не принимается.
Снижение Pending и RESOURCE_SEMAPHORE должно объяснять улучшение пользовательского времени. Если вместо них выросли spill, I/O или очередь приложения, оценка продолжается. Краткая серия без жалоб не доказывает прохождение месячного закрытия — для него нужен отдельный этап наблюдения.
План возврата относится к конкретному изменению: восстановить прежнее расписание, снять точечный hint либо вернуть поддержанную версию изменения отчёта. Перезапуск всего SQL Server не является стандартной обратной операцией. Для настройки памяти сохраняется прежнее значение и оценивается влияние на ОС, а для широкой смены compatibility требуется отдельный проект.
В мониторинге я соединяю устойчивое ожидание выдачи, длительность полезной операции и данные о потребителях. Сигнал «Pending однажды был больше нуля» слишком шумный; сигнал «операция вышла за допустимое время, одновременно наблюдается очередь grants» уже помогает начать расследование с правильного слоя.
Комплект, итог и вопросы коллегам
В комплекте статьи — четыре read-only SQL-файла, PowerShell-сборщик, три отдельно помеченных лабораторных сценария, две инструкции и матрица приёмки. Обычный сбор не запускает нагрузку, не создаёт базу и не меняет права. Скрипты требуют просмотра перед запуском; блоки LAB нельзя переносить на рабочий SQL Server.
Мы прошли от свободных процессоров до очереди рабочей памяти, нашли выдачу и ожидание, отделили текущий объём от завершённого использования, рассмотрели feedback и проверку исправления под конкурентной нагрузкой.
Ключевая мысль: нужно измерять не только занятые ресурсы, но и работу, которой ещё не разрешили начаться. Свободный CPU ничего не говорит о возможности получить grant, а большой grant сам по себе не доказывает ошибку запроса.
Спасибо, что дочитали. Коллеги, поделитесь в комментариях:
- Какой отчёт оказался источником давления, хотя сам пользователь не считал его медленным?
- Как вы сопоставляете SQL-сеанс с операцией 1С при использовании пула соединений?
- Приходилось ли получать меньшую очередь grants ценой большего spill — и как вы выбирали приемлемый баланс?
Следующая полезная развилка — исчерпание рабочих потоков: запрос уже не ждёт память сортировки, но экземпляру не хватает workers, чтобы обслуживать накопившуюся конкурентную работу.