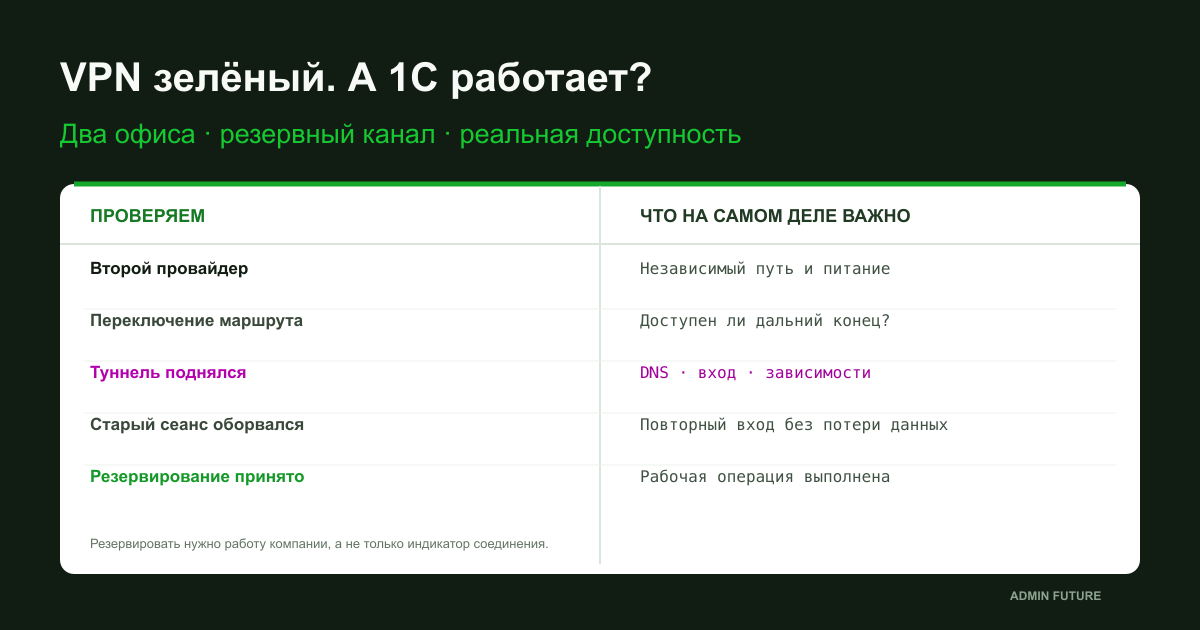
В филиале было девять утра. Сотрудник открыл заказ, начал добавлять позиции и услышал из соседнего кабинета: «У тебя тоже зависло?» Через минуту перестали отвечать все окна 1С. Интернет при этом работал: новости открывались, мессенджер принимал сообщения. На панели маршрутизатора резервный канал горел зелёным. VPN, судя по статусу, тоже был поднят.
Директор задал вполне логичный вопрос: «Мы же специально купили второй интернет. Почему снова стоим?» Администратор посмотрел на два активных интерфейса и понял неприятную вещь: он проверял наличие резерва, но никогда не проверял, какую работу этот резерв действительно сохраняет.
Ниже — учебный, составной кейс, а не отчёт об аварии конкретного заказчика. Адреса и имена вымышлены. Мы построим понятную архитектуру для двух офисов и удалённых сотрудников, разберём её слабые места и доведём проект до испытаний. Не будем обещать, что любое соединение переживёт любой отказ. Будем точно знать, что обязано восстановиться, за какое время и как это проверить.
1. Начинаем не с маршрутизатора, а с рабочего дня
Фраза «филиалу нужна 1С» слишком короткая для проектирования. Под ней может скрываться файловая база на сетевой папке, клиент-серверная база, веб-публикация или терминальный сервер. У этих вариантов разные зависимости и характер сетевой нагрузки. Сначала администратор садится рядом с пользователем и наблюдает обычную операцию: вход, открытие базы, поиск контрагента, проведение документа, печать, выгрузка файла.
В нашем проекте база работает на центральной площадке. Пользователи филиала запускают клиент 1С в сеансе RDS, а не обращаются через WAN к файловой базе. Сервер приложений и SQL находятся рядом. Это выбранная для кейса архитектура, а не универсальный рецепт: другой компании может лучше подойти защищённая веб-публикация или прямой клиент через VPN.
На листе появляются не только «1С» и «интернет», но и корпоративный DNS, вход в домен, лицензирование, файловый обмен и печать. Для каждой зависимости уточняем владельца, направление соединения и последствия потери. Если сотрудник может открыть базу, но не может сохранить документ, доступность ещё не восстановлена.
Затем согласуем измеримый результат: при отказе одного WAN новая рабочая сессия должна стать доступна в установленное компанией время. Краткий разрыв старой сессии допустим, потеря подтверждённой записи — нет. Конкретные секунды здесь не выдумываем: их выбирает бизнес, а стенд и испытание показывают, достижимы ли они.
2. Один сервер 1С остаётся одним сервером
У названия статьи есть важное ограничение. Мы резервируем сетевой путь, а не превращаем единственный сервер в отказоустойчивый кластер. Отказ SQL, гипервизора, дискового массива или электропитания центральной серверной не лечится вторым провайдером филиала. Эти риски должны оставаться в реестре, а не исчезать из него после покупки LTE-модема.
Полезно нарисовать цепочку: сотрудник → рабочая станция → локальная сеть → маршрутизатор → канал → VPN → центральная сеть → RDS → 1С → база. Рядом — DNS и аутентификация. Если на каком-то звене только один экземпляр, пишем это прямо. Для каждого отказа выбираем один из трёх ответов: автоматическое резервирование, ручное восстановление или согласованный простой.
Такая честность делает проект сильнее. Директор видит, за что именно платит: не за «теперь ничего не упадёт», а за переживание определённого набора отказов. Администратор получает границы ответственности и перестаёт доказывать, что исправный резервный интернет обязан оживлять сломанный сервер приложений.
3. Адресный план: ошибка, которую дешевле не совершать
Первый сюрприз обнаруживается ещё до VPN: обе площадки живут в 192.168.1.0/24. Для каждого офиса это раньше было удобно. Теперь клиент не знает, где находится удалённый адрес: у него за стеной или за туннелем. Обычная маршрутизация не может различить два одинаковых адресных пространства только потому, что администратор назвал одно «филиалом».
В учебной схеме выделим центральным серверам 10.44.10.0/24, центральным рабочим станциям 10.44.20.0/24, филиалу 10.44.30.0/24, удалённым сотрудникам 10.44.40.0/24, управлению 10.44.90.0/24. Это примеры частных сетей, не готовые значения для вашей компании. Перед выбором проверяют все офисы, облака, партнёрские VPN и домашние сети сотрудников.
Разделение необходимо не ради красоты таблицы. Оно позволяет разрешить филиалу доступ к конкретному RDS-серверу, не давая доступ ко всем рабочим станциям и интерфейсам управления. Отдельный пул удалённых сотрудников помогает отличать пользовательский вход от межофисного трафика. Управление получает собственный контур допуска, а не просто необычный номер VLAN.
Если пересечение уже существует, переадресация обычно чище постоянного обходного NAT. Но миграция требует инвентаризации статических адресов, DHCP, DNS, ACL и устройств, которые никто не трогал годами. Временная трансляция может помочь переходу; её фиксируют как технический долг с понятными границами, а не выдают за прозрачную сеть.
4. Два договора ещё не означают два независимых пути
Администратор звонит второму оператору и спрашивает не скорость тарифа, а путь кабеля. Оказывается, две услуги заходят в здание по одному стояку и питаются от одного оборудования на этаже. При строительных работах или отключении питания исчезнут обе. Резерв существует в бухгалтерии, но не в физической инфраструктуре.
Нужно выяснить общие точки отказа: ввод в здание, канализацию, оборудование оператора, электропитание, последнюю милю. Полной прозрачности может не быть; неизвестное так и помечают. Мобильный канал часто даёт иной путь, но зависит от покрытия, загрузки базовой станции, лимитов тарифа и питания локального оборудования.
Далее проверяем не рекламную скорость, а способность резервного канала обслуживать нужную нагрузку. Несколько RDS-сеансов, загрузка файлов и видеозвонок могут конкурировать иначе, чем тест скорости в пустом офисе. На резерве можно ограничить обновления и массовые выгрузки, сохранив приоритет рабочему доступу. Приоритеты не создают дополнительную полосу; они управляют тем, кто получает дефицитную.
И ещё: центральная площадка тоже должна иметь доступный резервный вход. Второй канал филиала бесполезен, если единственный публичный endpoint VPN в центре исчез вместе с центральным провайдером.
5. Выбираем архитектуру туннелей до настройки failover
Для кейса выберем два независимых маршрутизируемых VPN-пути между площадками: предпочтительный и резервный. На центральной стороне предусмотрены доступные через разные WAN точки входа. Внутренние адреса сервисов при переключении не меняются. Трафик пользователей идёт к тем же RDS и DNS, меняется транспорт доставки.
Это принцип, а не утверждение, что любые два туннеля автоматически покрывают все сочетания отказов. Если первый связан только с WAN-A, а второй только с WAN-B на обеих площадках, при некоторых комбинациях доступных каналов связи не окажется. В проекте составляют матрицу «WAN филиала → endpoint центра»: какие пары должны работать и как они выбираются. Иногда нужны дополнительные туннельные пути, иногда достаточно доступности обоих endpoint через выбранный WAN.
VPN может быть IPsec, WireGuard или иной поддерживаемый продукт. Нужно знать, как конкретная реализация выбирает endpoint, маршруты и обратный путь. Для WireGuard нельзя бездумно записать одинаковые AllowedIPs нескольким peer одного интерфейса и ожидать независимой маршрутизации. Отдельные интерфейсы и однозначные маршруты часто делают схему понятнее, но требуют проверки на выбранной платформе.
Адреса внешних endpoint должны достигаться через физический WAN, а не уходить внутрь того самого туннеля, который они поддерживают. Эта рекурсия выглядит забавно на рисунке и очень грустно в рабочее утро.
6. Схема, которую можно понять в три часа ночи

На эксплуатационной схеме нужны названия интерфейсов, внутренние подсети, endpoint туннелей, таблицы маршрутизации, зоны безопасности и места наблюдения. Пароли и приватные ключи туда не помещают. Хорошая схема объясняет путь одного пакета в обе стороны, а не просто показывает два облака и красивый замок.
Обозначаем, где проверяется работоспособность WAN, где проверяется туннель и где выполняется прикладной тест. Эти проверки не взаимозаменяемы. Рядом храним краткую таблицу нормального состояния: предпочтительный путь, резервный путь, ожидаемый DNS и допустимый набор сервисов. Её сверяют с реальной конфигурацией после каждого изменения.
Когда дежурный открывает схему, он должен ответить на вопрос: «По какому пути прямо сейчас возвращается ответ от RDS к филиалу?» Если рисунок отвечает только на прямое направление, половина сети остаётся воображаемой.
7. Сначала снимаем нормальное состояние
До первого отключения кабеля записываем исходные данные. На клиенте — IP, шлюз, DNS, выбранный интерфейс и маршруты. На двух граничных устройствах — активные маршруты, счётчики правил, состояние туннелей. На серверной стороне — доступность зависимостей и результат рабочей операции. Часы синхронизированы, время событий записывается с часовым поясом.
# Windows PowerShell 5.1. Read-only on an authorized test client.
Get-Date -Format o
Get-NetIPConfiguration
Get-DnsClientServerAddress -AddressFamily IPv4
Get-NetRoute -AddressFamily IPv4 |
    Sort-Object DestinationPrefix,RouteMetric |
    Select-Object DestinationPrefix,NextHop,InterfaceAlias,RouteMetric
Get-DnsClientNrptPolicy -Effective
# Capture the same evidence before, during and after the failure.
Команды выше ничего не перенастраивают. Но даже диагностический вывод может раскрывать структуру компании, поэтому его не публикуют целиком. Сравнение «до» и «после» часто полезнее десятка новых инструментов: тот же клиент, тот же сервер, тот же набор проверок.
Отдельно фиксируем, что считается успешной операцией: например, в согласованной тестовой базе пользователь входит, создаёт учебный документ, сохраняет его и повторно открывает. В production не проводят фиктивные финансовые документы ради сетевого теста. Владелец приложения выбирает безопасный сценарий и подтверждает результат.
8. Что именно означает «провайдер работает»
Первый вариант failover проверяет ближайший шлюз. Это обнаружит некоторые локальные проблемы, но не аварию дальше в сети оператора. Шлюз отвечает, интернет за ним недоступен, а основной маршрут остаётся предпочтительным. На панели всё зелёное — до тех пор, пока не спросить сотрудников.
Второй вариант проверяет внешний адрес. Теперь важно, чтобы проба была закреплена за проверяемым WAN. Иначе после переключения она уйдёт через резерв, увидит успех и объявит основной канал здоровым. Получится датчик, который проверяет дверь соседа и докладывает о состоянии вашей.
Практически полезны несколько уровней: состояние интерфейса, достижимость внешних точек через конкретный WAN, доступность нужного VPN-endpoint, путь внутри туннеля и прикладная операция. Но не каждую ошибку приложения следует превращать в команду переключить весь офис. Если SQL остановлен, бесконечная смена провайдеров только добавит шум.
В документации MikroTik есть пример WAN failover с рекурсивными маршрутами и закреплёнными проверочными адресами. Это ориентир механизма, а не готовый конфиг для любой версии RouterOS. Параметры scope, target-scope, таблиц и фактическое разрешение next-hop проверяют на своей версии и стенде. Официальный пример MikroTik.
9. Почему один неответивший ping не должен командовать офисом
Одна проверочная точка может ограничивать ICMP или временно исчезнуть по собственной причине. Если на каждый пропуск немедленно менять маршрут, сеть начнёт колебаться между каналами. Пользователь почувствует не один отказ, а серию обрывов, созданных системой защиты.
Задаём критерий отказа: число последовательных ошибок, несколько независимых целей и логику принятия решения. Задаём критерий восстановления отдельно: основной путь должен стабильно проходить проверки некоторое время, прежде чем забрать трафик обратно. Это гистерезис — способ не дёргать переключатель на границе состояния.
Точные интервалы зависят от транспорта, допускаемого простоя и ложных срабатываний. Не стоит обещать «переключение за секунду», не измерив обнаружение, смену маршрута, восстановление туннеля, повторное подключение клиента и прикладной вход. Быстрое решение маршрутизатора — только один участок этой последовательности.
Иногда разумнее пережить короткую деградацию, чем немедленно перебросить сотню соединений на тесный резерв. Это не повод скрывать проблему: её записывают, показывают влияние и проверяют, соответствует ли выбранная политика требованиям бизнеса.
10. Возвратный маршрут: половина расследования
Филиальный маршрутизатор выбрал резерв. Запрос дошёл до центрального сервера. Сервер ответил центральному шлюзу, а тот отправил ответ по старому предпочтительному туннелю. На одном конце счётчик растёт, на другом почти ничего не видно. Администратор начинает подозревать VPN, хотя шифрование вообще не является проблемой.
Маршрутизацию проверяют в обе стороны: от филиального клиента к центральной подсети и от центральной подсети к филиалу. Stateful firewall, правила по интерфейсам, connection marks и проверки обратного пути могут сделать асимметрию неприемлемой даже при формально существующих маршрутах.
Для каждого резервного пути определяем, как другая сторона узнаёт об изменении. Это могут быть отслеживаемые статические маршруты, динамическая маршрутизация через туннели или согласованная политика. Выбирают минимально сложный вариант, который покрывает реальные отказы. Добавление динамического протокола не отменяет необходимость контролировать соседство, фильтрацию маршрутов и ошибочные объявления.
# RouterOS 7: authorized router, read-only inventory.
# Verify commands against your installed release; redact before sharing.
/system resource print
/interface print detail
/ip address print
/ip route print detail
/routing table print
/routing rule print detail
/ip firewall mangle print stats
/ip firewall nat print stats
/ip firewall filter print stats
# Do not publish addresses, peer identities or a full configuration export.
В RouterOS отдельно сверяют policy routing и FastTrack: ускоряемый трафик не должен обходить нужную политику выбора таблицы. Документация описывает ограничения обработки, но конкретные исключения требуют анализа правил, а не массового отключения ускорения на загруженном устройстве. Packet Flow, Policy Routing.
11. NAT и соединения, которые помнят прошлое
Маршрут можно изменить, но уже установленное TCP-соединение не обязано стать новым. Оно связано с адресами и портами двух сторон. Если прямое соединение в интернет теперь выходит с другого публичного IP, удалённый сервер обычно видит другую пару endpoint. Сохранить его одним изменением default route нельзя.
В VPN ситуация может быть лучше: внутренние адреса клиента и сервера остаются прежними, а внешний транспорт меняется. Тогда часть внутренних соединений способна пережить короткую паузу, если новый путь действительно доставляет тот же трафик и не истекли таймеры. Это возможность, а не гарантия. Поведение зависит от туннеля, conntrack, приложения и длительности разрыва.
RouterOS применяет NAT к первому пакету соединения и хранит результат в connection tracking. Поэтому новые правила и новый маршрут не означают, что старое состояние исчезло. Masquerade и фиксированный src-nat ведут себя по-разному при изменении интерфейса или адреса. Документация NAT.
Команда «очистить весь conntrack» способна оборвать посторонние рабочие соединения. Её не используют как первый диагностический шаг. Сначала сравнивают новую сессию со старой, смотрят конкретный поток и понимают, какую запись собираются затронуть. Между непересекающимися офисными сетями в нашем проекте NAT не нужен: нормальные маршруты сохраняют видимость источников.
12. WireGuard: handshake не является проверкой 1С
У туннеля есть собственная правда: peer доступен, пакеты аутентифицированы, транспорт работает. У пользователя другая: имя RDS разрешается, вход проходит, база открывается. Первая правда не доказывает вторую. Это особенно важно при UDP-туннеле за NAT: наличие недавнего обмена ещё не показывает доступность внутренней подсети.
# Linux WireGuard endpoint. Authorized local access; read-only.
date --iso-8601=seconds
ip -brief address
ip rule show
ip route show table all
sudo wg show all latest-handshakes
sudo wg show all transfer
# Peer public keys and counters can identify infrastructure: redact exports.
# An old handshake is not automatically a fault on an idle peer.
# An active handshake is not an application acceptance test.
PersistentKeepalive помогает поддерживать NAT-сопоставление, когда оно действительно требуется. Он не является монитором провайдера или бизнес-операции. В официальном quick start WireGuard объясняется именно эта задача. На спокойном peer старый handshake сам по себе также не доказывает неисправность: нужно создать разрешённый полезный трафик и наблюдать результат. WireGuard Quick Start.
Отдельно проверяем смену внешнего endpoint. Нельзя предполагать, что DDNS-запись мгновенно изменит endpoint у всех реализаций клиента. Кеширование, период повторного разрешения и выбранный механизм переключения должны быть известны. Для аварийного доступа хранится документированная процедура, не зависящая от памяти одного администратора.
13. DNS: интернет появился, корпоративная сеть — ещё нет
В первой аварии филиал получал DNS от основного провайдера. После переключения публичные имена разрешались через резерв, но внутреннее имя RDS перестало находиться. Пользователь сказал «1С не работает», а сеть ответила на ping по IP. Противоречия нет: проверялись разные зависимости.
Клиентам нужен предусмотренный проектом корпоративный DNS, доступный по рабочему и резервному пути. Публичный resolver не является резервом для внутренних зон Active Directory. Удалённому сотруднику нужен корректный split-DNS: корпоративные имена обрабатываются корпоративными resolver, остальные — согласно политике. Одной записи в инструкции «поставить DNS центра» недостаточно, если маршрут к нему исчезает при отказе.
# Replace these documentation-only names and IP before running.
$DnsServer = '192.0.2.53'
$RdsName = 'rds.corp.example.net'
Resolve-DnsName -Name $RdsName -Type A -Server $DnsServer -ErrorAction Stop
Resolve-DnsName -Name $RdsName -Type A -ErrorAction Stop
Test-NetConnection -ComputerName $RdsName -Port 3389 -InformationLevel Detailed
# This example uses direct RDP INSIDE the VPN, not a public RDP listener.
# A successful TCP test does not prove authentication or a working 1C session.
Сравниваем явный запрос к нужному DNS и обычное разрешение на клиенте. Так видно, проблема в сервере, доставке запросов или выборе resolver. Проверяем A и AAAA там, где используется IPv6: исправный IPv4 не делает ошибочную IPv6-конфигурацию безопасной. Изменение DNS endpoint через короткий TTL тоже не гарантирует сохранение открытых соединений.
В нашем кейсе RDS-сеанс может продолжить жить на сервере при потере сети, но новый вход потребует доступных служб аутентификации. Поэтому испытание проводится не только с уже вошедшим пользователем, но и с новой авторизацией.
14. Отдельный вход сотрудников, отдельное доверие
Межофисный VPN связывает известные сети через управляемые устройства. Удалённый пользователь приходит с ноутбука, домашнего роутера и иногда заражённого окружения. Это другой уровень доверия. Давать ему тот же доступ, что филиальному маршрутизатору, только потому, что технология VPN одинаковая, — плохая граница безопасности.
Выделяем отдельный пул адресов, собственные правила, персональную идентичность и отзыв доступа. Где выбранный продукт поддерживает MFA — включаем её и проверяем аварийный сценарий. WireGuard сам по себе не добавляет интерактивную MFA поверх ключей; для этого нужна подходящая система доступа, а не надпись «MFA» на схеме.
Корпоративные маршруты ограничены необходимыми сервисами. Полный туннель или split tunnel выбирают с учётом модели угроз и управления устройствами. В обоих случаях проверяют IPv6, DNS и возможное обходное направление. Split tunnel не должен случайно открывать путь из домашней сети в корпоративную через неправильную пересылку.
При смене центрального провайдера удалённый пользователь тоже должен знать резервный путь входа. Межофисный failover не обновляет автоматически все ноутбуки. Проверяем опубликованные адреса, клиентские профили, сертификаты и инструкцию повторного подключения.
15. Филиалу не нужен доступ ко всей серверной
После недели нормальной работы возникает соблазн разрешить две подсети целиком: так проще и меньше звонков. Но филиал — отдельная зона, а не продолжение доверенного коммутатора. Взлом одной рабочей станции не должен давать доступ к консоли гипервизора, backup-серверу и интерфейсу управления маршрутизатором.
Начинаем с запрещения лишнего и разрешаем документированные потоки: пользователи → RDS, разрешённые DNS-запросы, требуемая аутентификация для выбранной модели, необходимый файловый обмен. Доменным компьютерам могут требоваться дополнительные службы AD; нельзя обещать полноценную доменную работу правилом «разрешить только 3389 и 53». Набор портов определяют по реальным ролям и официальной документации.
Административный доступ идёт через отдельный защищённый путь с персональными учётными записями. Правила действуют и на резервном туннеле. Иначе резервирование становится скрытым обходом firewall: в штатном режиме всё ограничено, в аварийном открывается вся инфраструктура.
При прямом клиентском подключении к кластеру 1С проверяют фактические endpoint и настроенный диапазон рабочих процессов. Доступность одного порта не гарантирует работу всей цепочки. В нашем варианте эти соединения остаются внутри центра, а наружу не публикуются ни SQL, ни административные порты 1С. Документация 1Ci по портам.
16. Пропускная способность и задержка: резерв без свободного воздуха
На пустом LTE-канале всё работало. Затем несколько сотрудников переподключились, браузеры начали обновления, а один человек отправил большую папку. Очередь выросла, задержка стала нестабильной, экран RDS начал реагировать рывками. Туннель не исчез, но работать было мучительно.
Для интерактивной работы важны задержка, потери и очередь, а не только мегабиты. Измеряем их под согласованной нагрузкой. Массовый тест скорости в рабочее время сам способен создать инцидент, поэтому его проводят в окне испытаний. Наблюдаем направление upload тоже: узкий исходящий канал может испортить все ответы.
На резерве ограничивают некритичные загрузки, проверяют корректную классификацию трафика и запас производительности маршрутизатора при шифровании. Правила QoS должны соответствовать реальной скорости канала, иначе очередь просто переедет в модем оператора. Для переменной мобильной полосы настройка сложнее фиксированного тарифного значения.
MTU и MSS проверяются отдельно, если маленькие запросы проходят, а большие зависают. Но этим нельзя объяснять любую деградацию. Если потоки медленные из-за забитой очереди или загруженного RDS, снижение MTU не заменит диагностику. Сначала устанавливаем наблюдаемый предел.
17. Почему новая сессия работает, а старая зависла
Это развилка, которая быстро сужает расследование. Если новый вход проходит и тестовый документ открывается, базовый путь уже восстановился. Зависшая старая сессия может ждать истечения сетевых таймеров или повторного подключения. Но нельзя из этого сразу заключить, что она потеряла все изменения либо что серверный процесс умер.
# Windows test client, inside the approved corporate VPN.
# Replace this documentation-only destination.
$Target = 'rds.corp.example.net'
Test-NetConnection -ComputerName $Target -DiagnoseRouting -InformationLevel Detailed
Get-NetTCPConnection -State Established |
    Where-Object { $_.RemotePort -eq 3389 } |
    Select-Object LocalAddress,LocalPort,RemoteAddress,RemotePort,OwningProcess
# Do not add -Port to -DiagnoseRouting: they use different parameter sets.
# ICMP/traceroute visibility does not necessarily reveal an encrypted path.
На RDS проверяют фактический статус сессии и настроенные лимиты отключения. Переподключение к существующему сеансу и создание нового — разные события. Поведение 1С дополнительно зависит от операции, которую она выполняла. Пользователю дают безопасную инструкцию: не повторять проведение документа вслепую, сначала проверить состояние в базе.
Если был прерван ответ на запись, клиент может не знать, завершилась ли операция на сервере. Нажать ещё раз — не всегда безобидно. Поэтому прикладной критерий восстановления включает проверку результата, а не просто исчезновение сообщения об ошибке. Сетевой инженер и владелец приложения должны договориться об этом заранее.
Проект может честно требовать повторного входа при определённом отказе. Это лучше ложного обещания «бесшовно», которое никто не испытывал. Для пользователей важна понятная процедура и отсутствие потери данных, а не слово на презентации.
18. Наблюдаемость: собираем одну временную линию
Нам нужны время обнаружения отказа, решение маршрутизатора, смена пути, состояние туннеля, первый успешный DNS-запрос, новая TCP-сессия и первая успешная рабочая операция. Если есть только график ping, невозможно сказать, где именно потерялись минуты.
# Passive evidence from an authorized Windows test client.
# Replace target/port if the application uses another endpoint.
$Target = 'rds.corp.example.net'
$Port = 3389
1..12 | ForEach-Object {
    $Started = Get-Date
    $Result = Test-NetConnection -ComputerName $Target -Port $Port -WarningAction SilentlyContinue
    [pscustomobject]@{
        Time=$Started.ToString('o')
        Target=$Target
        Tcp=$Result.TcpTestSucceeded
        Source=$Result.SourceAddress
        Remote=$Result.RemoteAddress
    }
    Start-Sleep -Seconds 5
}
# Each probe creates a NEW connection; it does not test session survival.
# Actual intervals exceed 5 seconds when a connection attempt times out.
Такой простой тест показывает появление новых TCP-соединений, но не непрерывность старого RDS-сеанса. Его соединяют с журналами маршрутизаторов, VPN, Windows и отметками пользователя. Временные метки приводят к одной шкале. В журнал не записывают пароли, приватные ключи и содержимое документов.
Система мониторинга отдельно сообщает «перешли на резерв» и «рабочий доступ недоступен». Первое важно для эксплуатации, второе — для бизнеса. Если резерв работает, дежурному не нужна сотня одинаковых тревог от каждого узла. Но сообщение о потерянной избыточности нельзя полностью скрыть: следующий отказ уже некуда переживать.
Возврат на основной путь тоже событие. Если после него появились обрывы, временная линия должна показать связь, а не заставить администратора гадать по воспоминаниям сотрудников.
19. Испытания, которые нельзя заменить выдёргиванием кабеля
Отключение WAN-кабеля полезно, но проверяет только один вид отказа. В отдельном согласованном окне моделируют недоступность за отвечающим шлюзом, потерю VPN-endpoint, недоступность корпоративного DNS, отказ центрального WAN и восстановление основного пути. Каждое испытание имеет точную границу, остановочный критерий и способ отката.
| Сценарий | Что наблюдаем | Критерий приёмки |
|---|---|---|
| Основной WAN филиала недоступен | Обнаружение, маршрут, VPN, новый вход | Рабочая операция восстановлена в согласованное время |
| Шлюз отвечает, внешний путь нет | Проверки закреплены за нужным каналом | Основной путь не признаётся здоровым через резерв |
| Потерян WAN центра | Доступность резервного endpoint с филиала и ноутбука | Работает предусмотренный резервный вход |
| Основной WAN восстановлен | Гистерезис, обратный путь, старые и новые сеансы | Нет бесконечных переключений, последствия документированы |
| DNS недоступен | Обычный и явный запросы, новая авторизация | Причина отделена от WAN; зависимость имеет свой план |
Не устраиваем «учебную аварию» без предупреждения production. Перед изменением сохраняют конфигурации устройств, проверяют независимый путь управления и знают, как вернуть исходный маршрут. Если администратор управляет тем же VPN, который отключает, заранее нужен локальный контакт или проверенная консоль. Иначе испытание сети превращается в поездку через весь город.
20. Возвращаемся к утренней аварии
В начале нашего учебного кейса существовали сразу несколько слабых мест. Проверка WAN смотрела только на ближайший шлюз. Корпоративный DNS не был корректно доступен на резервном пути. А при смене туннеля центр сохранял предпочтительный обратный маршрут. Покупка второго канала не устранила ни одну из этих ошибок.
Теперь администратор не объявляет причину по зелёному индикатору. Он сравнивает нормальное состояние с аварийным: внешний маршрут филиала изменился, доставка к endpoint есть, внутренний запрос виден на центральной стороне, ответ уходит в другой туннель. После исправления симметрии IP-доступ появился; сравнение DNS-запросов отдельно выявило ошибку resolver. Это последовательность доказательств, а не победа любимой гипотезы.
Новая RDS-сессия открылась. Старая переподключилась согласно проверенному поведению и настройкам. Владелец приложения проверил документ в тестовой базе. Только после этого время восстановления стало измеренным результатом. В статье нет выдуманного числа секунд: его нужно получить в своей сети.
Разница между старой и новой системой не в количестве кабелей. Раньше были компоненты. Теперь есть определённые пути, наблюдаемые состояния и подтверждённое возвращение работы.
21. Что оставляем после проекта
На выходе остаются адресный план, схема прямых и обратных маршрутов, матрица доступных WAN-пар, перечень разрешённых потоков, правила мониторинга, процедура переключения и протокол испытаний. У каждого документа есть владелец и дата проверки. Конфигурационные копии хранятся защищённо, секреты — отдельно.
Пользовательская инструкция занимает меньше страницы: как распознать разрыв, сколько ждать, куда сообщить и как проверить результат операции перед повтором. Административная инструкция объясняет, как попасть на устройства без рабочего основного VPN и как вернуться к исходному состоянию. Не должно быть пункта «позвонить человеку, который помнит».
Испытания повторяют после смены провайдера, VPN-продукта, правил firewall, DNS или архитектуры приложения. Вчерашний успешный тест не является вечной гарантией. Неиспользуемый резерв склонен стареть незаметно: истёк сертификат, изменился тариф, оператор закрыл входящие соединения, новый ноутбук получил только основной профиль.
Когда директор снова спросит «у нас резерв есть?», ответ будет точнее: «При этих отказах новая рабочая операция восстанавливается так; эти сеансы могут оборваться; такие риски ещё остаются». Это и есть взрослая отказоустойчивость. Не зелёная лампочка, а проверенное обещание с понятными границами.
22. Первичные источники и дальнейшее чтение
Механизмы и ограничения сверены по официальным материалам. Архитектура и сюжет выше — самостоятельный учебный проект; документы производителей не являются доказательством его работоспособности без испытаний.
- MikroTik: Failover — WAN Backup — рекурсивные маршруты и проверки WAN.
- RouterOS NAT — трансляция и connection tracking.
- RouterOS Policy Routing и Packet Flow — выбор таблиц и ограничения обработки.
- WireGuard Quick Start — endpoint и PersistentKeepalive.
- 1Ci: Ports Setup — фактические порты кластера и рабочих процессов.
- Microsoft: Remote Desktop Disconnections — диагностика отключений RDS.