В этой статье
Вчера в 14:37 база записала неправильный результат
Привет, коллеги. Я Максим, системный администратор. Вчера в 14:37 оператор завершила в 1С обработку, которую запускать было не нужно: часть документов списалась дважды. Она сразу позвонила и сказала честно: «Я нажала не то». Паники не было, база работала дальше, коллеги продолжали вводить документы. На сервере PostgreSQL ничего не упало и не зависло.
Первая мысль в такой ситуации обычно простая: взять ночную копию и вернуть базу назад. Вторая мысль приходит через секунду: с момента копии прошла половина рабочего дня. В базе уже есть правильные операции других людей, оплаты, отгрузки. Вернуть всё назад — значит выбросить их работу вместе с ошибкой оператора.
Разберём учебный случай: сервер srv-pg-01, кластер PostgreSQL с базой 1С trade_1c, фирма example. Имена вымышленные, это не отчёт о клиентской аварии. Ночью делалась файловая копия, WAL архивировались на отдельный сервер. Будем восстанавливать данные к моменту перед ошибкой — в изолированной копии, не трогая работающий production. В конце получим проверяемый результат: восстановленное состояние на 14:36, из которого владелец конфигурации извлечёт нужные документы и вернёт их в рабочую базу контролируемым способом.
Команды рассчитаны на PostgreSQL с включённой архивацией WAL. Если архивация не настроена заранее, честный ответ будет в разделе про границы метода: вернуться в 14:37 без цепи WAL нельзя, и я не буду делать вид, что можно.
Почему откат всей базы — проигрышный ход
Смотрю на часы. Ошибка случилась в 14:37. Ночная копия сделана в 02:00. Между ними — двенадцать с половиной часов работы десятков людей. Если я разверну базу из копии в production, вместе с ошибкой исчезнут и их документы. Утром выяснится, что мы обменяли одну аварию на другую, и вторая будет больше первой.
Есть и второй довод, технический. Ночная копия у нас файловая, сделанная на уровне каталога кластера. А если бы вместо неё был pg_dump? Логическая выгрузка полезна для миграций и переноса между серверами, но она не участвует в восстановлении по журналу. Документация PostgreSQL прямо предупреждает: pg_dump и pg_dumpall не создают файловой копии и не могут быть частью решения с проигрышем WAL. Восстановление по журналу стартует с файловой копии кластера, а не с SQL-дампа.
Значит, ищем способ вернуть только утраченное. Такой способ существует, но он опирается на то, что сервер уже ведёт журнал опережающей записи, — а ведёт он его всегда, независимо от наших желаний. Осталось понять модель.
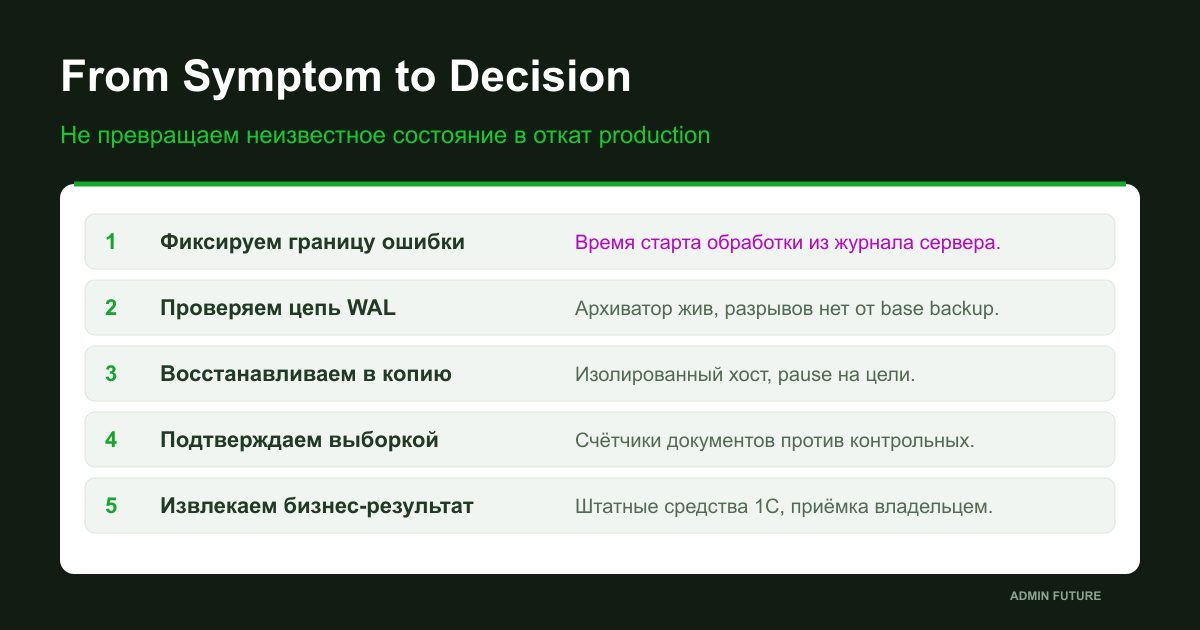
WAL уже содержит и ошибку, и правильную работу
WAL — журнал опережающей записи. Каждое изменение данных сначала попадает в этот журнал, и только потом сервер считает транзакцию подтверждённой. Это механизм аварийной безопасности: после сбоя сервер перечитывает журнал и приводит файлы данных в согласованное состояние.
Для нас важно другое свойство: в WAL попадает всё подряд. И ошибочная обработка оператора в 14:37, и правильные документы коллег до и после неё. Журнал ничего не знает о наших намерениях — он фиксирует факты.
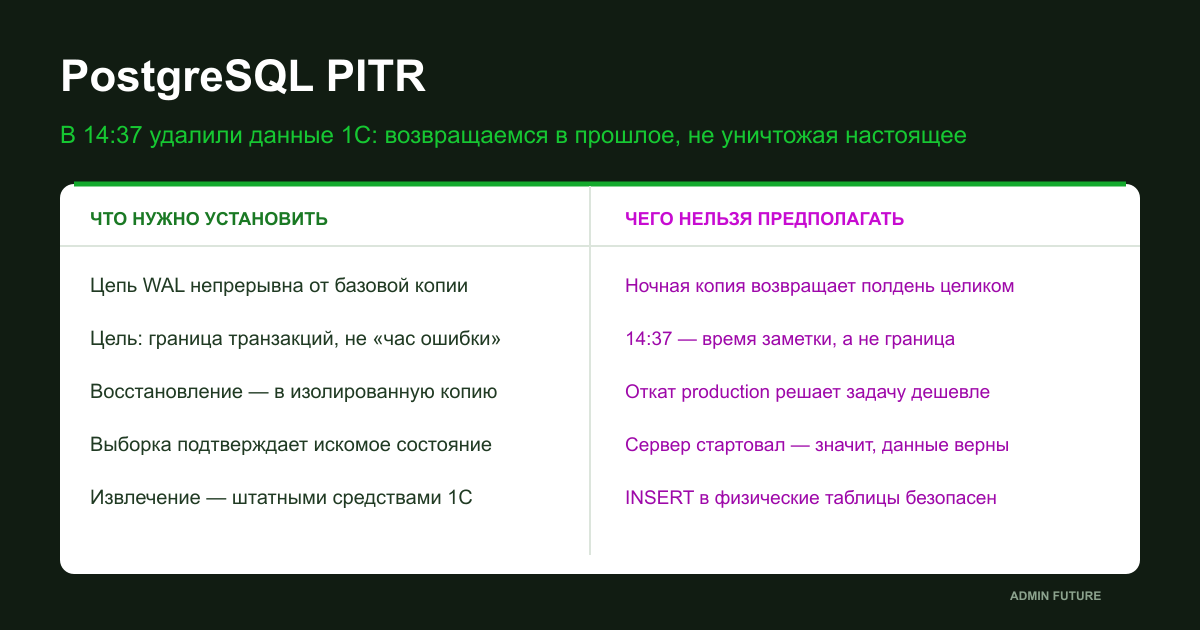
Отсюда главный вывод метода: проигрыш журнала без точки остановки воспроизведёт в копии базы и ошибку, и всё остальное. Мы не «отменяем» обработку оператора — мы умеем остановить повтор истории за секунду до неё. Именно поэтому задача звучит не «откатить», а «восстановить к моменту времени» — point-in-time recovery, PITR.
Замечу и про место хранения. Незаполненные журнальные файлы живут в каталоге pg_wal внутри кластера. Если там кончится место, сервер остановится аварийно: документация описывает это как PANIC shutdown — подтверждённые транзакции не теряются, но база не работает, пока место не освободят. Сегодня нам важно, что заполненные сегменты уходят в архив, и дальше решает уже цепь.
Модель: базовая копия плюс непрерывная цепь WAL
Механизм PITR стоит на двух ногах. Первая — базовая копия: снимок файлов кластера, сделанный штатно, на работающем сервере, через pg_basebackup. Вторая — непрерывная цепь архивных сегментов WAL, начинающаяся не позже начала этой копии.
Почему цепь должна быть непрерывной? При восстановлении сервер берёт файлы копии и переписывает поверх них журнал, начиная с той позиции, на которой копия стартовала. Каждый пропущенный сегмент — это дыра в истории. Сервер дойдёт до разрыва и остановится, потому что следующее изменение уже не восстановить. Документация формулирует условие жёстко: для успешного восстановления нужна непрерывная последовательность архивных WAL, уходящая назад как минимум до начала базовой копии.
Важная деталь, которую легко пропустить: pg_basebackup сам по себе не гарантирует архивацию WAL, сгенерированных во время копирования. Гарантию даёт связка: архиватор настроен и работает, а сервер ждёт архивации последнего нужного сегмента перед завершением копии. Процесс копирования создаёт backup history file — маленький файл с меткой, начальным и конечным сегментами. Он попадает в архив и говорит нам, откуда начинать проверку цепи.
Пока сервер жив и архивация работает, цепь растёт сама. Наша работа — убедиться, что она растёт без разрывов.
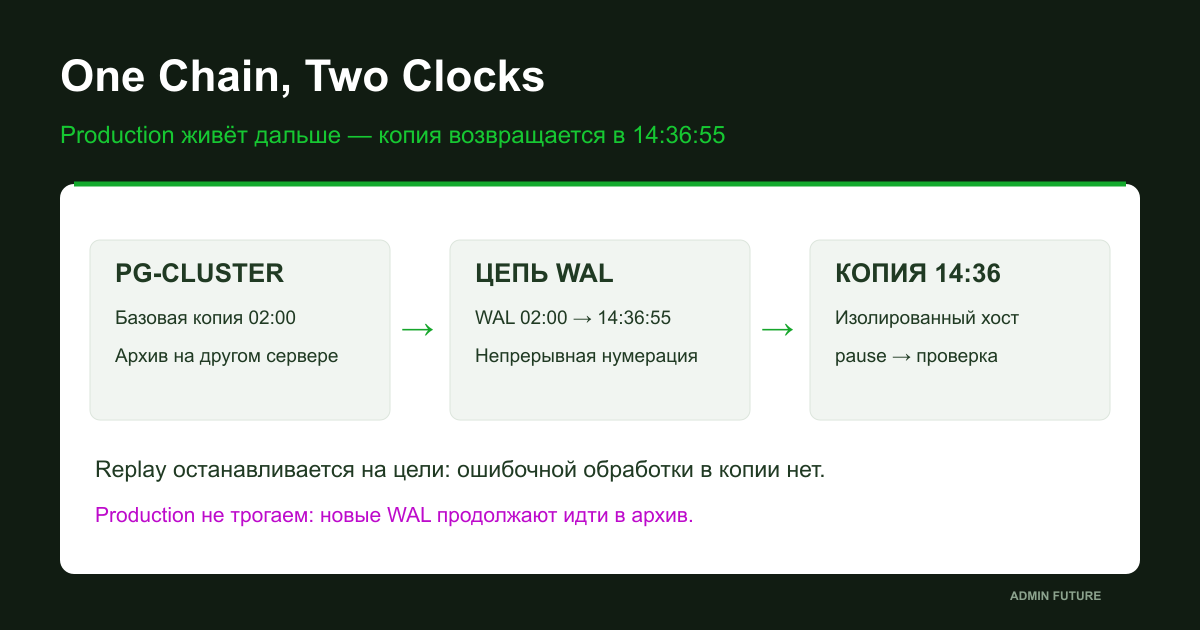
Проверка архивации до того, как она понадобится
Сначала читаем состояние, ничего не меняя. PostgreSQL ведёт статистику архиватора в представлении pg_stat_archiver. Она отвечает на три вопроса: когда последний сегмент успешно ушёл в архив, сколько попыток завершилось неудачей и не застрял ли архиватор на одном файле.
-- Read-only. On the primary, any database.
SELECT archived_count, failed_count,
       last_archived_wal, last_archived_time,
       last_failed_wal, last_failed_time,
       stats_reset
FROM pg_stat_archiver;
-- archived_count is a lifetime counter: look at fresh last_archived_time
-- and a failed_count that is NOT growing. A stuck last_archived_wal
-- with a growing failed_count means the chain is not being extended.
Что здесь важно интерпретировать правильно. Поле archived_count, растущий день ото дня, — хороший знак, но сам по себе не доказательство: он считает успешные архивации за всю жизнь статистики. Важнее связка: last_archived_time свежий, failed_count не растёт. Если failed_count увеличивается, сервер долбится в архив и откладывает — и каждый такой день цепь не дополняется, а pg_wal накапливает необработанные сегменты.
Дальше — проверка целевого каталога. Файлы архива лежат там, куда их кладёт archive_command. Имена сегментов несут позицию в абстрактной последовательности WAL, и по имени видно, что за чем следует. Переходим к самой цепи.
Целая цепь решает, один файл — нет
Восстанавливаемость — свойство цепи, а не отдельного файла. Утилита покажет, что ночная копия на месте, и это ничего не скажет о том, восстановимся ли мы к 14:37.
Проверяю непрерывность программно: беру имена архивных сегментов, сортирую и ищу разрывы в нумерации. Скрипт читает каталог архива, ничего не изменяет, и пишет первый пропущенный интервал, если он есть.
#!/usr/bin/env bash
# pitr-chain-check.sh — read-only WAL archive continuity check.
# Usage: ./pitr-chain-check.sh /srv/wal-archive
# Exits 0 if no gaps found, 1 on the first missing interval.
set -euo pipefail
ARCHIVE="${1:-}"
if [[ -z "$ARCHIVE" || ! -d "$ARCHIVE" ]]; then
  echo "Usage: $0 /path/to/wal/archive" >&2
  exit 2
fi
segments=$(find "$ARCHIVE" -maxdepth 1 -type f -regextype posix-extended \
  -regex '.*/[0-9A-F]{24}' | sort)
if [[ -z "$segments" ]]; then
  echo "No WAL segment files found in $ARCHIVE" >&2
  exit 2
fi
prev=""
count=0
while IFS= read -r seg; do
  name=$(basename "$seg")
  count=$((count + 1))
  if [[ -n "$prev" ]]; then
    # Sequential segment names differ by 1 in the last 8 hex digits.
    prev_tail=$((16#${prev:16}))
    cur_tail=$((16#${name:16}))
    if (( cur_tail - prev_tail != 1 )); then
      echo "GAP: after $prev the next file is $name (expected +1)" >&2
      echo "Check from $prev forward: the chain is broken before $name" >&2
      exit 1
    fi
  fi
  prev="$name"
done <<< "$segments"
echo "OK: $count WAL segments, no numbering gaps."
echo "Note: this checks segment NAMES, not their content."
echo "Start boundary: the first segment must not be newer than the base backup start"
echo "(see the newest *.backup history file in the same archive)."
Три честные оговорки. Во-первых, скрипт проверяет непрерывность имён, а не содержимое: битый файл с правильным именем он не заметит — для этого у сервера есть собственная проверка при replay. Во-вторых, граница проверки — начало базовой копии: всё, что старше ближайшего backup history file, для восстановления из этой копии не нужно. В-третьих, проверку надо делать регулярно, а не в день аварии: разрыв, найденный в 14:40 вчерашнего дня, лечится настройкой архивации; разрыв, найденный сегодня, может оказаться фатальным для задачи.
# Read-only. Where does the WAL chain start for the newest base backup?
# Archive layout (example): /srv/wal-archive/<segment-name>
ls -1 /srv/wal-archive/*.backup
# Newest history file points at the first WAL segment of that backup:
#   START WAL LOCATION: 0/4000028 (file 000000010000000000000040)
# Everything from that segment forward must be present and unbroken.
Цепь цела, архивация жива. Теперь решаем, где остановить повтор истории.
Точка остановки: время — не граница транзакции
Цель восстановления задаётся параметром recovery_target_time — меткой времени, до которой проигрывается журнал. Формат тот же, что у типа timestamp with time zone, и документация советует писать смещение от UTC или полное имя зоны: сокращения вроде MSK сервер может не понять.
Тонкость в том, что 14:37:00 — это время, когда мы заметили проблему, а не граница транзакции. Обработка оператора стартовала в 14:35:52 и фиксировала изменения пачками. Если поставить цель 14:36:59, в копию попадёт половина её транзакций — состояние будет хуже понятного: половина документов списана, половина нет. Параметр recovery_target_inclusive управляет границей: остановиться сразу после указанной цели или сразу перед ней.
Что делать администратору, если точная граница неизвестна? Искать её в журнале сервера: время начала обработки видно по записям о подключениях и запросам. Ставлю цель на пару секунд раньше старта обработки — включительности хватит, чтобы не захватить ни одной её транзакций. Другие типы целей — по номеру транзакции, LSN или имени — сведём в таблицу ниже, они решают те же задачи точнее, когда известен идентификатор.
| Параметр цели | Что задаёт | Когда выбирать | Оговорка |
|---|---|---|---|
| recovery_target_time | Метку времени остановки | Граница известна по времени (журнал сервера) | 14:37 — время заметки, не граница транзакции; нужен запас |
| recovery_target_xid | Номер транзакции | Известен XID ошибочной транзакции | XID выдаются при старте, фиксируются в другом порядке |
| recovery_target_lsn | Позицию LSN в журнале | Позиция видна из метрик/журналов | Требует чтения LSN, не время |
| recovery_target_name | Именованную точку | Точка создана заранее через pg_create_restore_point | Точная граница по построению; нужна привычка ставить точки |
| recovery_target_inclusive | Остановиться после/перед целью | Уточнение границы на одну запись | Работает с time/xid/lsn |
| recovery_target_action | Действие на цели: pause / promote / shutdown | pause — для проверки до решения | shutdown: recovery.signal останется, старт снова остановится |
# postgresql.conf of the ISOLATED copy. Adjust the target, do not copy blindly.
restore_command = 'cp /srv/wal-archive/%f %p'
recovery_target_time = '2026-11-03 14:36:55+03'
recovery_target_inclusive = false
recovery_target_action = 'pause'
# pause: stop AT the target, allow read-only inspection, then decide.
# Wrong target? Shut down, change the value, start again:
# a new timeline branch is created, the archive is not harmed.
Восемь строк конфигурации, которые мы ещё применим на изолированной копии. Пока это план, не действие.
Предохранитель до ошибки: именованные точки восстановления
Лучшая точка восстановления — та, что создана до ошибки, а не угадана после неё. PostgreSQL умеет фиксировать именованные метки в журнале: pg_create_restore_point. Перед рискованной обработкой — свёрткой, групповым изменением, массовым перепроведением — точка ставится одной командой и попадает в WAL вместе с остальной историей.
-- Before a risky batch job. Requires rights for pg_create_restore_point.
SELECT pg_create_restore_point('before_bulk_recalc_20261103') AS restore_point_lsn;
-- The mark lands in WAL. It is a label, not a snapshot:
-- useful only together with working WAL archiving.
-- After the job: if it went wrong, recovery_target_name='before_bulk_recalc_20261103'
Имя говорит само за себя: before_bulk_recalc_20261103. Если обработка пойдёт не так, цель восстановления recovery_target_name ссылается на эту метку, и граница транзакций получается точной по построению — не нужно вычислять её из журнала задним числом.
Оговорки. Точка фиксируется в журнале, а не создаёт снимок: она имеет смысл только вместе с рабочей архивацией. Имена в одном журнале не должны повторяться в рамках восстановления — используйте уникальные метки с датой. Команда требует соответствующих полномочий, но она читает и пишет одну запись журнала: это не тяжёлая операция.
В идеальном мире именованные точки ставятся регламентно: любая обработка, о которой администратор узнаёт заранее, получает свой предохранитель. В нашем учебном случае предохранителя не было, поэтому идём по времени старта обработки.
Timelines: эксперименты не должны затирать историю
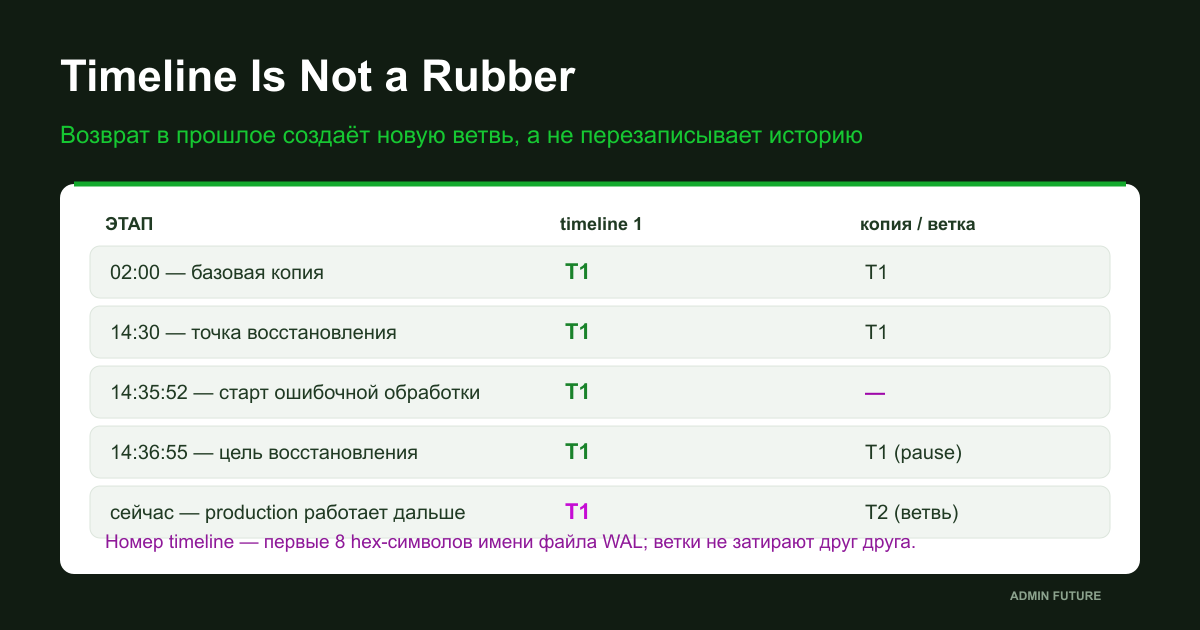
Восстановление к прошлому создаёт парадокс, который документация PostgreSQL честно сравнивает с путешествиями во времени. Мы развернули копию на 14:36 и дали людям с ней работать. Копия генерирует свои журнальные записи. Если эти записи пойдут в тот же архив, они перезапишут сегменты, ведущие к другим вариантам истории, — и вернуться в исходную ветку станет невозможно.
Решение встроено в механизм: timelines. Каждое завершённое восстановление порождает новую ветвь истории, а номер timeline входит в имена файлов WAL — первые восемь шестнадцатеричных символов. Ветки не затирают друг друга. Не угадали точку остановки с первого раза? Восстанавливаемся заново в другую ветвь, не боясь испортить архив — файл истории с расширением .history фиксирует, откуда ветвь отделилась.
Практическое следствие для нашей аварии: изолированная копия, которую мы сейчас поднимем, после проверки может стать новым primary, а может быть выброшена. В обоих случаях архив остаётся цел — благодаря ветвлению, а не благодаря нашей аккуратности. Ещё следствие: файл .history мал, и документация советует хранить его в архиве вместе с сегментами бессрочно; комментарий в нём с причиной ветки окупится при следующем расследовании.
Изолированная площадка для возврата
Восстановление делаем не на production. Причины простые: копия кластера будет носить то же имя базы, те же порты, и она не должна отвечать пользователям, пока мы её не проверили. Кроме того, место: на время восстановления нужно дисковое пространство под полный кластер и архив WAL, которые будут перечитаны.
Площадка у нас есть: тестовый хост restore-01 в том же сегменте, с доступом к архиву по NFS. Требования к ней скромные: тот же major-версии PostgreSQL, достаточно места, закрытый сетевой доступ к портам базы до завершения проверки.
Две вещи, которые я делаю до первого запуска. Первая: pg_hba.conf в копии закрыт для всех, кроме локального административного подключения — даже если площадка изолирована, привычка дешёвая. Вторая: архив WAL доступен на чтение, и ничто в моих командах не пишет в архив. Каталог кластера копируется, а не переносится: оригиналы архива и резервная копия остаются нетронутыми, чтобы при ошибке начать заново без потерь.
Сервер production за это время продолжает работать и накапливать новые WAL — цепь пополняется, и это нормально: наша точка остановки в прошлом, новые сегменты её не портят.
Первый прогон восстановления
Порядок действий на площадке воспроизводим по документации: разложить файлы базовой копии, очистить каталог pg_wal от того, что приехало внутри копии, записать restore_command, создать файл recovery.signal и запустить сервер. Сервер войдёт в режим восстановления и начнёт читать архив.
# On the isolated host (restore-01), as the postgres OS user. Example paths.
set -euo pipefail
# 1) Clean target directory; nothing from previous attempts must remain.
rm -rf /var/lib/pgsql/pitr-copy
mkdir -p /var/lib/pgsql/pitr-copy
# 2) Copy (not move!) the base backup. Originals stay untouched.
cp -a /srv/basebackup/latest/. /var/lib/pgsql/pitr-copy/
# 3) Segments inside the backup are stale: the archive is authoritative.
rm -rf /var/lib/pgsql/pitr-copy/pg_wal
mkdir -p /var/lib/pgsql/pitr-copy/pg_wal
# 4) Recovery configuration (see the recovery target block above).
cp /var/lib/pgsql/pitr-copy/postgresql.conf /var/lib/pgsql/pitr-copy/postgresql.conf.orig
vi /var/lib/pgsql/pitr-copy/postgresql.conf
# 5) Marker: while it exists, the server is in archive recovery.
touch /var/lib/pgsql/pitr-copy/recovery.signal
# 6) Start and watch the log: replay position, pause at the target.
pg_ctl -D /var/lib/pgsql/pitr-copy -l /var/lib/pgsql/pitr-copy.log start
tail -f /var/lib/pgsql/pitr-copy.log
Три места, где я не экономлю внимание. Во-первых, на шаге 2 файлы копируются, а не переносятся — после неудачного прогона не нужно просить резервную копию заново. Во-вторых, pg_wal очищается: сегменты из копии устарели, а свежие сегменты сервер возьмёт из архива; если я оставлю старые, получу путаницу версий. В-третьих, recovery.signal — это маркер: пока он существует, сервер считает себя восстанавливающимся; целевой каталог должен быть пуст от прошлых запусков.
recovery_target_action=pause остановит повтор на цели и оставит сервер в состоянии, когда можно подключиться и смотреть данные, но нельзя писать. Это именно то, что нужно для проверки: смотреть до того, как решать судьбу копии.
Результат проверяем до вывода в мир
Копия стоит на паузе. Подключаюсь локально и проверяю состояние.
-- On the isolated copy, local connection, after the pause.
SELECT pg_is_in_recovery() AS in_recovery,
       pg_is_wal_replay_paused() AS replay_paused;
SELECT pg_last_wal_replay_lsn() AS replay_lsn,
       pg_last_wal_receive_lsn() AS receive_lsn;
-- Sampled business counters (teaching example: 1C document tables).
-- Compare with the production numbers reported BEFORE the incident.
SELECT count(*) AS posted_docs_before_target
FROM doc_journal WHERE posted_at < '2026-11-03 14:36:55+03';
SELECT count(*) AS bad_batch_traces
FROM doc_journal WHERE batch_id = 'bulk_recalc_20261103';
-- Expected: pause at target = true; bad_batch_traces = 0.
-- Mismatch = stop, refine the target, replay again into a new branch.
Что здесь доказывает каждый результат. Первая строка: сервер на паузе именно там, где мы его остановили — recovery дошла до цели. Вторая: текущая позиция повтора сравнима с журналом сервера, по которому мы вычисляли границу. Третья и четвёртая: счётчики документов на выборку — операции до 14:36 на месте, признаков обработки оператора нет.
Если числа не сошлись — не трагедия, а ветвь. Останавливаю сервер, уточняю цель по журналу, запускаю снова. Timeline разведёт новую ветку, архив не пострадает. Так выглядит итерация поиска точки: дёшево, обратимо, с доказательством на каждом шаге.
Только когда выборка подтвердила, что копия несёт ровно то состояние, которое мы искали, копия заслуживает права на следующий этап: извлечение бизнес-результата. Пока нет — это учебная копия, и решения по ней не принимаются.
Бизнес-результат извлекаем, а не вставляем
Дальше работа делится на две разные задачи, и смешивать их опасно. Первая — инженерная: у нас есть копия кластера в правильном состоянии. Вторая — прикладная: вернуть утраченные данные в рабочую базу так, чтобы 1С считала их своими.
Прямой вставки строк в физические таблицы здесь не будет. Таблицы 1С связаны логикой конфигурации: документ, его движения по регистрам, счета, проводки. Физически корректный INSERT способен дать данные, которые платформа не признает или признает с повреждением ссылочной целостности. Правильный инструмент — штатные средства платформы: обработка выгрузки/загрузки данных, перепроведение документов, свёртка по правилам владельца конфигурации. Администратор базы обеспечивает копию; прикладное извлечение делает тот, кто отвечает за конфигурацию.
Порядок приёмки у нас такой. Владелец конфигурации в изолированной копии выгружает документы, затронутые ошибкой, вместе с сопутствующими справочниками. В production загружается пакет, и владелец проверяет: документы на месте, движения корректны, отчёты сходятся. Только после его подписи копия отправляется в архив как «ветка восстановления от такого-то числа».
Оговорка про масштаб: если ошибка тронула сотни тысяч объектов, ручная выгрузка нереалистична — тогда решение о частичном переносе принимает владелец конфигурации, вплоть до варианта, когда копия становится новой рабочей базой, а накопленные за вечер операции переносят в неё. Это бизнес-решение, не административное.
Границы метода
Соберу границы в одном месте, потому что каждая из них когда-нибудь сэкономит вечер.
Восстанавливается кластер целиком, а не выбранная таблица или база. Нужны данные одной базы из кластера — восстанавливаем всё и работаем с нужным. Запрашивать PITR одного отношения нельзя.
Непрерывность решает всё. Разрыв в цепи между базовой копией и целью делает восстановление невозможным после разрыва. Регулярная проверка цепи из предыдущего раздела — не рутина, а страховка.
Повреждённый WAL останавливает восстановление: сервер остановится на первом битом сегменте и не стартует, пока цель не перенесут за точку повреждения. Документация описывает и этот путь: перезапустить восстановление с целью до повреждения.
Конфигурационные файлы в WAL не попадают: postgresql.conf, pg_hba.conf и pg_ident.conf правятся вручную, и их изменения архив не помнит. Копия конфигурации — отдельная забота.
wal_level ниже replica делает PITR невозможным: минимальный уровень не пишет строки для постоянных отношений, создаваемых или переписываемых транзакцией, и документация предупреждает, что смена уровня на minimal делает прежние базовые копии непригодными для PITR. Плюс целый класс ограничений: CREATE TABLESPACE пишет в WAL абсолютный путь и воспроизведётся с тем же путём; изменение шаблонных баз во время копии может протечь в восстановление.
Из всего списка самая частая реальная граница — первая: метод возвращает кластер, а не документ. Отсюда и архитектура статьи: копия несёт состояние, бизнес-результат из неё извлекают средствами платформы.
Когда PITR не поможет
Честность метода — знать, когда он бессилен. Три ситуации из практики.
Архивация не настроена заранее. WAL существует, но заполненные сегменты перезаписываются в pg_wal и не уходят наружу. К 14:37 вчерашнего дня нужные сегменты уже переработаны — вернуться в 14:36 физически не к чему. Спасёт только то, что лежит в обычных копиях: ночной снимок или логический дамп. Вывод не «PITR плох», а «архивацию надо было включить до аварии». После чтения этой статьи — включить до аварии.
Архив или диск с ним потеряны. Цепь цела, но лежит на том же хранилище, что и база, и хранилище умерло вместе с сервером. Отдельный носитель для архива — не паранойя, а условие самого метода. Если архив уезжает на другой сервер, проверяйте доступность этого сервера в сценарии «основной мёртв».
Повреждение затронуло и архив, и текущий каталог. Тогда разговор уже не про 14:37, а про последнюю проверенную копию и про standby, если он есть. Это сценарий другой статьи и другой проверки.
| Ситуация | pg_dump (логическая копия) | Файловая копия без WAL | Base backup + цепь WAL (PITR) |
|---|---|---|---|
| Нужно перенести базу на другой сервер | Подходит: переносит схему и данные | Избыточен и рискован без выключенной базы | Избыточен |
| База разрушена, нужна вся база на вчерашнее утро | Восстановит на момент выгрузки | Восстановит на момент снимка | Восстановит на любой момент внутри цепи |
| Ошибочная обработка в середине дня, production живёт дальше | Не поможет: правильные операции после дампа потеряются | Не поможет: та же граница ночного снимка | Восстанавливает кластер к моменту перед ошибкой в изолированную копию |
| Зона честной применимости | Миграции, выгрузка по фильтрам | Аварийный снимок целиком | Возврат истории без остановки production |
Сравнение инструментов выше — не украшение, а карта «что спасёт в какой ситуации». Каждая колонка — честный инструмент со своей зоной покрытия.
Приёмка после чтения и профилактика
Итог учебного расследования: production не тронут, цепь WAL цела, изолированная копия поднята на 14:36:55 и подтверждена выборкой, владелец конфигурации извлёк из неё документы и вернул их в рабочую базу штатной обработкой. Оператор продолжила работу. Авария стоила нам вечера, а не половины рабочего дня чужих документов.
Полезное действие после чтения одно: проверить архивацию WAL на своём сервере сегодня, пока она не нужна. Две команды из раздела про pg_stat_archiver и скрипт цепи из комплекта ответят на вопрос «а мы вообще сможем вернуться в 14:37» честным да или честным нет.
Комплект к статье: скачиваемый архив pitr-kit.zip — скрипт проверки цепи WAL, критерии приёмки восстановления RU/EN и список первоисточников.
Профилактика, которая делает следующую аварию скучной: именованная точка восстановления перед каждой рискованной обработкой; регулярная проверка цепи по расписанию; тренировочное восстановление в изолированную копию хотя бы раз в квартал — успешный backup не подтверждает восстановимость; архив WAL на отдельном носителе; и фиксация фактических RPO и RTO после тренировки, а не до.
| Критерий | Как проверяем | Что означает успех |
|---|---|---|
| Архивация работает | pg_stat_archiver + свежий last_archived_time, failed_count не растёт | Цепь пополняется сейчас, не «вчера была настроена» |
| Цепь непрерывна | Скрипт pitr-chain-check.sh по каталогу архива от начала последнего base backup | Разрывов нет; первый разрыв назван явно |
| Цель восстановления обоснована | Граница взята из журнала сервера (старт обработки), а не из памяти | Цель раньше первой транзакции ошибочной обработки |
| Изоляция восстановления | Копия поднята на отдельном хосте, pg_hba закрыт, в архив не пишется | Production не затронут ни чтением пользователей, ни записью |
| Состояние подтверждено выборкой | pg_is_wal_replay_paused, replay LSN, контрольные счётчики документов | Копия несёт ровно искомое состояние |
| Бизнес-приёмка | Владелец конфигурации выгрузил документы и сверил отчёты в production | Данные возвращены штатными средствами платформы |
| Фактические RPO/RTO записаны | Замеры тренировочного восстановления зафиксированы | Цифры измерены, а не оценены |
Вопросы коллегам, на которые я бы хотел знать ответы заранее: кто в вашей команде умеет читать backup history file и найти начало цепи? Сколько часов займёт восстановление кластера на тестовый хост — меряли? Что произойдёт с архивом WAL, если основной сервер проработает без ребутов ещё год — место на диске архива не кончится?