В прошлой статье про Docker была одна фраза, мимо которой многие проскочили не задумываясь: «членство в группе docker фактически равносильно root на хосте». Не «почти равносильно», не «в теории равносильно при определённых условиях» — буквально равносильно, за одну команду. Если у вас на сервере есть хоть один человек с доступом к Docker-сокету, но без права на sudo, у вас на самом деле нет такого разделения прав, которое вы думаете, что у вас есть. «Админ» узнаёт об этом на аудите безопасности, когда пентестер за 30 секунд эскалируется от «просто разработчика» до root. «Архитектор» узнаёт об этом заранее — и либо осознанно принимает этот риск, либо убирает его целиком через rootless-режим, о котором и пойдёт речь.
Эта статья — прямое продолжение предыдущей, но её можно читать и отдельно. Разберём три слоя: почему root-демон Docker — это не «удобная деталь реализации», а реальная модель угроз; как устроен rootless-режим изнутри и что он на самом деле меняет; и что делать сверх rootless, если контейнеры держат по-настоящему недоверенный код.
1. Один сокет, который может всё
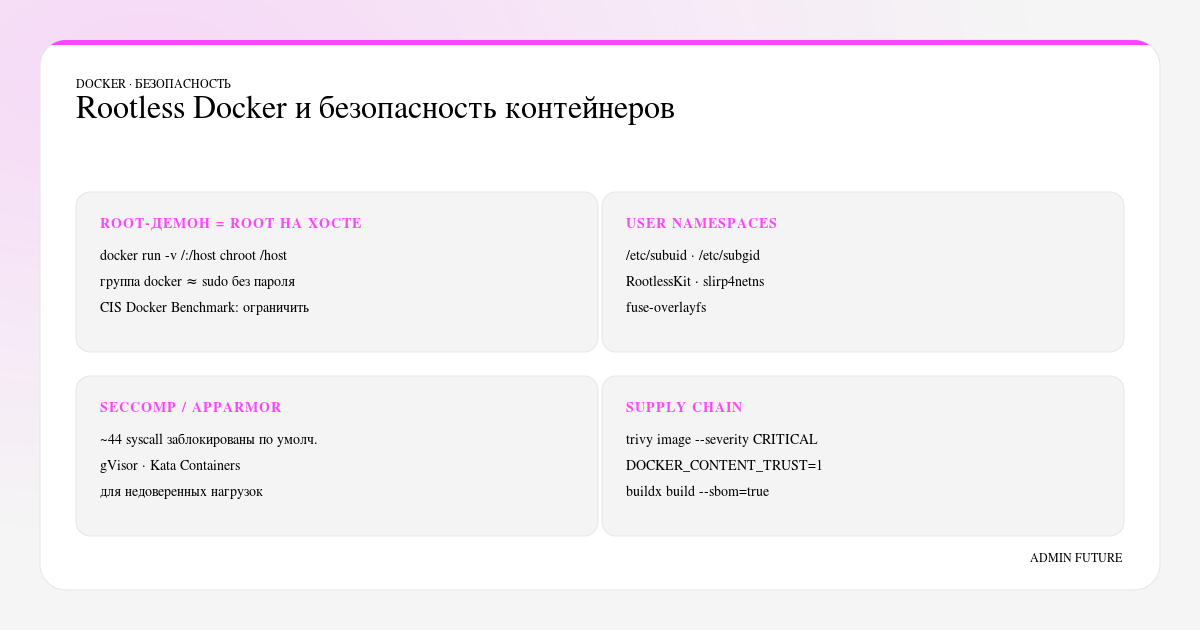
Стандартный Docker устроен как клиент-серверная модель: команда docker, которую вы набираете в терминале — это тонкий клиент, а вся реальная работа происходит в демоне dockerd, который слушает Unix-сокет /var/run/docker.sock и работает от имени root. Клиент просто отправляет туда HTTP-запросы поверх сокета. Проблема не в том, что демон работает от root — для управления namespaces, cgroups и сетевыми интерфейсами root действительно нужен на уровне ядра. Проблема в том, что любой, у кого есть доступ к этому сокету, получает возможность попросить root-процесс сделать буквально что угодно — включая примонтировать корень хостовой файловой системы внутрь нового контейнера:
Bash — эскалация за одну команду, если у вас есть доступ к docker.sock
# Монтируем корень хоста внутрь контейнера и chroot'имся в него —
# теперь вы root на хосте, а не «пользователь в группе docker»
docker run --rm -it -v /:/host chroot /host

# Работает даже без -v: спрятать привилегии через --privileged
# или капабилити ядра тоже никто не мешает попросить у демона
docker run --rm --privileged -it alpine sh
Это не эксплойт и не уязвимость в смысле CVE — это документированное, ожидаемое поведение Docker. Демон делает ровно то, о чём его просят, а группа docker — это не «ограниченный доступ к контейнерам», это неограниченный доступ к корневому демону, который умеет монтировать что угодно куда угодно. CIS Docker Benchmark отдельным пунктом прямо требует ограничивать членство в этой группе строго необходимым минимумом именно по этой причине.
💡 Мысленная модель, которую стоит унести из этого раздела: в стандартном Docker вопрос «сколько человек могут запускать контейнеры» и вопрос «сколько человек имеют root на хосте» — это один и тот же вопрос с двумя разными формулировками, а не два разных уровня доступа.
2. Как rootless на самом деле убирает root из уравнения
Rootless Docker — это не «Docker с урезанными правами», это буквально другая архитектура запуска демона: dockerd и всё, что он порождает, работает от имени обычного непривилегированного пользователя, без единого root-процесса на хосте вообще. Звучит просто, но три вещи, которые раньше требовали root на уровне ядра — сетевые namespace’ы, монтирование файловых систем и создание самих user namespaces — приходится решать без него. Вот как это устроено на практике:
- User namespaces и subuid/subgid — ядро Linux с 2013 года умеет создавать user namespace, внутри которого процесс видит себя как UID 0 (root), а снаружи, на хосте, у него реальный непривилегированный UID вроде 1000. Диапазон дополнительных UID для этого маппинга берётся из
/etc/subuidи/etc/subgid— именно поэтому первым шагом установки rootless всегда идёт проверка, что эти файлы вообще заполнены для вашего пользователя. - RootlessKit — обёртка, которая на старте демона создаёт user namespace и mount namespace без единого вызова root, и уже внутри них запускает сам
dockerd. Это тот компонент, который делает возможным запуск всей конструкции вообще безsudoна любом этапе. - slirp4netns (или VPNKit) — сеть в контейнере, работающем без root, не может напрямую создавать виртуальные интерфейсы и настраивать iptables на хосте, поэтому сетевой стек эмулируется полностью в user space, через TAP-интерфейс и user-mode TCP/IP стек. Плата за это — заметный оверхед по сравнению с обычным bridge-networking, обычно измеряемый в единицах — десятках процентов пропускной способности, в зависимости от паттерна нагрузки.
- fuse-overlayfs — классический OverlayFS (тот самый union-filesystem из первой статьи) в большинстве ядер требует root для монтирования. fuse-overlayfs даёт то же самое поведение слоёв через FUSE, без root-привилегий на монтирование.
Итоговый эффект — если атакующий каким-то образом вырывается за пределы изоляции контейнера (реальный побег из namespace, а не просто ошибка конфигурации), он оказывается не root на хосте, а тем самым непривилегированным пользователем, от которого запущен весь демон. Это не делает побег из контейнера невозможным — это делает его результат на порядок менее катастрофичным.
3. Установка и миграция: пошагово
На сентябрь 2026 rootless-режим — не экспериментальная фича, а полноценно поддерживаемый способ установки, включённый прямо в официальный скрипт установки Docker. Разница с обычной установкой из прошлой статьи — буквально один флаг:
Bash — Ubuntu / Debian
# Предпосылки: uidmap для newuidmap/newgidmap, и subuid/subgid
# уже должны быть заполнены для вашего пользователя (обычно так и есть
# по умолчанию в современных Ubuntu/Debian — но лучше проверить явно)
sudo apt-get install -y uidmap dbus-user-session fuse-overlayfs
grep "^$(whoami):" /etc/subuid /etc/subgid

# Если после docker-ce-cli/containerd.io уже стоит обычный (root) Docker —
# для чистоты эксперимента можно поставить rootless рядом, они не конфликтуют
curl -fsSL https://get.docker.com/rootless | sh

# Скрипт сам подскажет две переменные окружения — добавьте их в .bashrc/.zshrc
export PATH=/home/$(whoami)/bin:$PATH
export DOCKER_HOST=unix:///run/user/$(id -u)/docker.sock

# Демон живёт как systemd user-сервис — не системный, а именно пользовательский
systemctl --user start docker
systemctl --user enable docker

# loginctl linger — чтобы демон не умирал при выходе из SSH-сессии
sudo loginctl enable-linger $(whoami)

# Проверка: та же команда, что и в прошлый раз, но теперь БЕЗ sudo —
# если требует sudo, значит вы всё ещё смотрите на системный демон
docker run --rm hello-world
docker info --format '{{.SecurityOptions}}'
Последняя команда — не формальность. docker info в rootless-режиме явно покажет name=rootless среди security options. Если вы что-то настраивали, а эта строчка не появилась — вы либо всё ещё работаете с системным демоном по старой переменной DOCKER_HOST, либо экспорт переменных не подхватился в текущей сессии.
4. То, что перестаёт работать — и почему это осознанный компромисс, а не баг
Rootless — не бесплатный обед. Три ограничения стоит знать заранее, чтобы не тратить вечер на отладку того, что на самом деле является ожидаемым поведением:
- Порты ниже 1024 напрямую не пробрасываются. Привязка к привилегированным портам (80, 443) требует root — а его как раз и нет. Решение — либо публиковать на непривилегированный порт (8080) и ставить перед ним системный reverse proxy от root (nginx, тот самый «архитекторский» подход из статьи про reverse proxy), либо разрешить непривилегированным процессам биндиться на низкие порты через
sudo sysctl net.ipv4.ip_unprivileged_port_start=80— это системная настройка ядра, а не настройка Docker, и она слегка расширяет то, что вообще может делать любой процесс в системе, не только контейнеры. - Нужны cgroups v2. Управление ресурсами (лимиты CPU/памяти из чек-листа в прошлой статье) в rootless-режиме работает только через cgroups v2 с delegation, включённую в systemd. В современных дистрибутивах (Ubuntu 22.04+, Debian 12+, Fedora) это уже стандарт из коробки; на старых системах с cgroups v1 лимиты ресурсов в rootless-режиме попросту не применятся — не с ошибкой, а молча, что гораздо хуже.
- Сетевой оверхед от slirp4netns. Для большинства веб-приложений и внутренних сервисов разница незаметна. Для высоконагруженных сетевых сервисов — например, обратного прокси, принимающего десятки тысяч запросов в секунду — стоит явно измерить пропускную способность на вашей конкретной нагрузке, а не полагаться на общие цифры из документации.
Практический вывод простой: для внутренних сервисов, CI-раннеров, сред разработки и большинства бэкенд-приложений эти ограничения либо не заметны, либо решаются одной строчкой конфигурации. Для узкоспециализированных высоконагруженных сетевых сервисов — стоит явно протестировать rootless на реальном профиле нагрузки, прежде чем переводить прод.
5. Rootless закрывает не все двери — что добавить сверху
Важно понимать границы: rootless меняет, кем вы становитесь при побеге из контейнера — он не делает сам побег невозможным. Если инфраструктура реально исполняет недоверенный код (мультитенантный SaaS, публичный CI, «выполни код пользователя» как фича продукта) — стоит комбинировать rootless с дополнительными слоями изоляции:
- Seccomp-профили — Docker и так применяет профиль по умолчанию, блокирующий около 44 потенциально опасных системных вызовов (например,
ptrace, монтирование файловых систем черезmount(2)). Для конкретного приложения можно написать свой профиль ещё строже — если процесс никогда не использует, скажем,ptrace, запретить его явно, а не полагаться только на дефолт. - AppArmor или SELinux — мандатный контроль доступа поверх обычных Unix-прав: даже если процесс внутри контейнера технически root (в своём user namespace) и обошёл capability-ограничения, профиль AppArmor/SELinux может явно запретить чтение конкретных путей на хосте вне зависимости от UID.
- gVisor или Kata Containers — когда namespace-изоляции реально недостаточно. gVisor (проект Google) перехватывает системные вызовы контейнера в userspace и сам реализует урезанное ядро поверх них — процесс внутри физически не может напрямую тронуть системные вызовы хостового ядра, даже если в нём найдётся 0-day. Kata Containers идёт ещё дальше: каждый контейнер получает собственную лёгкую виртуальную машину с отдельным ядром — то самое разделение, которое даёт VM, но с UX и скоростью запуска, близкими к обычному контейнеру. Плата — заметно больший расход ресурсов и более медленный холодный старт, поэтому это осознанный выбор для конкретных недоверенных нагрузок, а не замена rootless везде подряд.
⚠️ Частая ошибка «Админа»: считать, что переход на rootless закрывает вопрос безопасности контейнеров целиком, и на этом остановиться. Rootless — это один слой из нескольких, причём слой, защищающий конкретно от последствий побега из-за привилегий демона. От уязвимости в самом ядре, которую использует контейнерный процесс для эскалации внутри своего namespace, rootless не защищает вообще — для этого нужны seccomp, AppArmor/SELinux и, для по-настоящему недоверенных нагрузок, gVisor или Kata.
6. Вторая половина проблемы: откуда вообще берётся образ
Всё, что было выше — про то, что происходит во время выполнения контейнера. Но у контейнера есть момент до этого — момент, когда вы скачиваете чужой образ с Docker Hub командой docker pull и запускаете его, толком не зная, что внутри. Это отдельная поверхность атаки, известная как supply chain — и закрывается она не изоляцией во время выполнения, а проверками до неё.
Bash — три проверки перед тем, как образ попадёт в прод
# Сканирование известных уязвимостей в пакетах внутри образа —
# тот же trivy, что упоминался в прошлой статье, но теперь как
# обязательный шаг CI, а не разовая ручная проверка
trivy image --severity HIGH,CRITICAL --exit-code 1 myapp:latest

# Проверка криптографической подписи образа (Docker Content Trust) —
# подтверждает, что образ пришёл именно от того издателя, который
# его подписал, и не был подменён между публикацией и вашим pull
export DOCKER_CONTENT_TRUST=1
docker pull nginx:1.27-alpine

# SBOM (Software Bill of Materials) — полный список того, что реально
# упаковано внутрь образа, генерируется прямо из BuildKit
docker buildx build --sbom=true -t myapp:latest .
docker buildx imagetools inspect myapp:latest --format '{{ json .SBOM }}'
SBOM особенно недооценён именно системными администраторами, привыкшими думать про инфраструктуру, а не про цепочку поставки кода: когда завтра выходит очередной CVE уровня log4j, вопрос «а есть ли у нас вообще эта библиотека где-то в проде» перестаёт требовать ручного аудита полусотни образов — достаточно один раз прогнать запрос по уже сгенерированным SBOM.
Чек-лист: от «Docker установлен» до «Docker установлен осознанно»
- Кто состоит в группе
docker? Если ответ «больше людей, чем должны иметь root на этом сервере» — это несоответствие стоит закрыть в первую очередь, до всего остального. - Rootless там, где это возможно — особенно на серверах разработки, CI-раннерах и любой машине, где Docker ставит один человек, а пользуются несколько.
- cgroups v2 включены, если лимиты ресурсов вообще должны работать в rootless-режиме — проверьте явно, не полагайтесь на «наверное, всё ОК».
- Seccomp-профиль по умолчанию не отключён флагом
--security-opt seccomp=unconfined«для удобства отладки» и забыт включённым в проде. - Для по-настоящему недоверенного кода — gVisor или Kata Containers как дополнительный слой, а не только namespace-изоляция.
- Сканирование образов и SBOM — часть CI, а не ручная проверка раз в квартал, если вообще когда-либо.
Вывод
Обычный Docker не небезопасен по умолчанию — он просто спроектирован с оптимизацией под удобство одного разработчика на своей машине, а не под модель угроз с несколькими недоверенными друг другу пользователями на общем сервере. Rootless-режим не «чинит» Docker — он приводит его модель прав в соответствие с тем, как контейнеры на самом деле используются в продакшене: не одним человеком, которому и так можно доверять root, а инфраструктурой, где root должен оставаться редким, осознанным исключением, а не побочным эффектом установки пакета.
Если из всей статьи запомнить одно — пусть это будет вопрос, который стоит задать себе прямо сегодня: сколько человек в вашей организации технически имеют root на серверах через членство в группе docker, и совпадает ли этот список с тем, кому вы реально готовы дать root?
Теги: #docker #linux #devops #безопасность #rootless #контейнеры #sysadmin #infosec
🚀 Хотите стать архитектором будущего, а не просто админом? Эта статья — лишь верхушка айсберга. В нашем Telegram-канале «Admin Future» мы каждый день публикуем системные гайды, готовые скрипты, AI-лайфхаки и чеклисты, которые не найти в Google. Мы не просто постим команды — мы строим библиотеку знаний для тех, кто хочет расти от админа до архитектора. Подписывайтесь и становитесь экспертом: Admin Future